

 Leina
 Wanta
Enseñar a la IA a elegir: 5 ideas de Skills para agentes inspiradas en Jev
Descubre cinco usos de Jev, desde música y personajes de videojuegos hasta selección de Skills. Conecta Jev mediante el Cloudflare Workers AI Provider de OOMOL o empieza a conversar con un Agent de Leina.
OOMOL
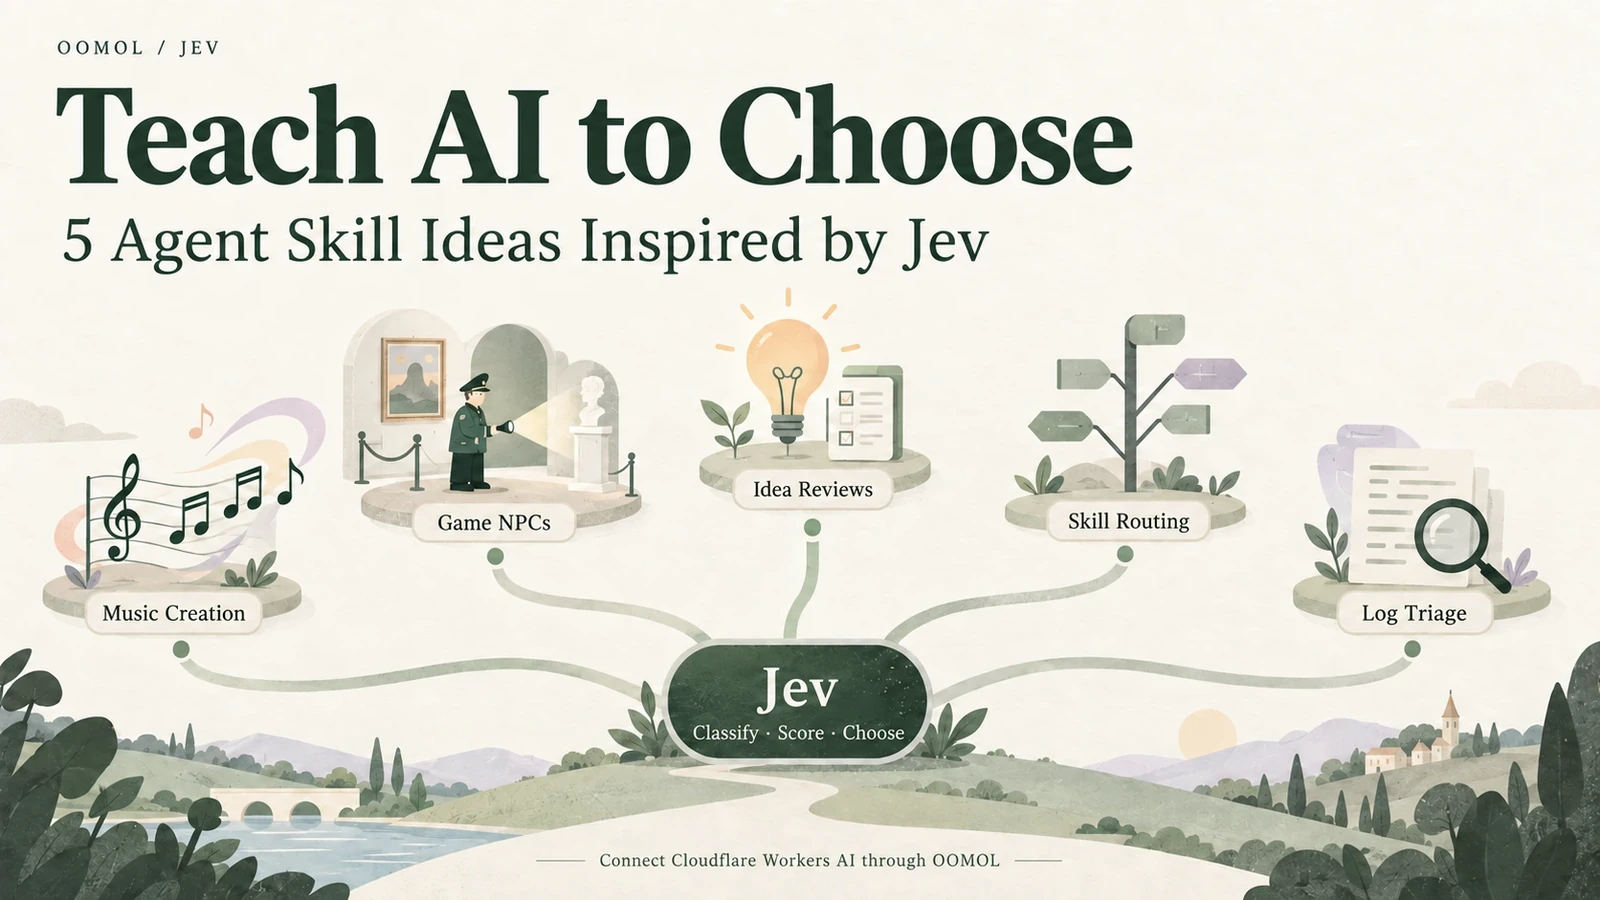
Tienes diez títulos preliminares. ¿Cuáles deberías conservar? Has instalado docenas de Skills. ¿Cuál se adapta a la próxima solicitud? Un guardia en un juego detecta a alguien sospechoso. ¿Debería seguir patrullando, hacer una pregunta o dar la alarma?
El resultado de cada tarea puede ser una sola opción, pero tomar esa decisión requiere comprender el contexto.
Jev, lanzado en acceso temprano por TypeSafe el 15 de septiembre de 2026, está diseñado para estas decisiones. Toma texto o estado estructurado y devuelve opciones o puntuaciones, junto con información de probabilidad, según tipos de preguntas predefinidos. Los desarrolladores pueden usar esos resultados para determinar qué hará su software a continuación. Introducción de TypeSafe
Actualmente, Jev acepta entrada de texto. Las imágenes, el audio y el video deben convertirse primero en descripciones de texto o campos estructurados para su evaluación. Requisitos de entrada
Para los lectores de OOMOL que trabajan con Agents y Skills, esto sugiere un enfoque útil: identificar un juicio recurrente en un flujo de trabajo, definir sus criterios y empaquetar la decisión y los pasos posteriores en una Skill reutilizable.
OOMOL ahora ofrece un Provider de Cloudflare Workers AI con soporte para Jev. Una vez conectado, puedes llamar a Jev desde tus flujos de trabajo de Agent y empezar a aplicar las ideas siguientes a tareas reales.
Cómo funciona Jev: Convierte juicios semánticos en resultados que el software puede usar
Jev está diseñado para decisiones estructuradas. TypeSafe llama a esta clase de modelos modelos System One. Una solicitud proporciona un state que contiene el material y el contexto a evaluar, además de questions que definen los juicios, los tipos de respuesta y los criterios. El modelo devuelve resultados tipificados que el código puede usar para ramificar, clasificar o enrutar. Visión general técnica
Hay tres tipos básicos de preguntas:
| Tipo | Propósito | Salida |
|---|---|---|
| Choice | Seleccionar una opción predefinida, como una categoría de mensaje | La opción seleccionada, una distribución de probabilidades y la confianza |
| Score | Evaluar un grado frente a niveles ordenados predefinidos | Un puntuación, una distribución sobre los niveles y la confianza; el puntuación puede ubicarse entre niveles |
| Noul | Juzgar si una afirmación específica es verdadera | Una probabilidad de “sí” de 0 a 1, sin un campo separado de confianza |
Las preguntas en una solicitud se evalúan de forma independiente y en paralelo contra el mismo estado. No ven las respuestas de las otras. Si un juicio posterior necesita el resultado de uno anterior, el código debe realizar una solicitud adicional. Tipos de preguntas y composición
Los modelos generativos de lenguaje suelen producir respuestas token a token. TypeSafe describe a Jev como un modelo que utiliza muestreo paralelo para salidas restringidas, devolviendo decisiones y probabilidades sin generar una respuesta de texto libre. Su método de entrenamiento es RLCD: Aprendizaje por refuerzo para decisiones calibradas, que busca alinear las probabilidades predichas con las frecuencias observadas. Diseño del modelo · Explicación de RLCD
Para un modelo bien calibrado, los eventos asignados con un 80% de probabilidad deberían ocurrir aproximadamente el 80% de las veces en muchas predicciones comparables. Esa es una meta estadística, no una garantía sobre una respuesta individual. El campo confidence en las respuestas de Choice y Score resume cuán concentrada está la distribución de probabilidades; no es simplemente la probabilidad de que la respuesta seleccionada sea correcta. El código sigue decidiendo cuándo actuar, solicitar más información o pedir una revisión humana, utilizando reglas validadas con ejemplos reales. Probabilidad y confianza
Un ejemplo sencillo: Enrutar el mensaje de un cliente
Imagina que una tienda online recibe este mensaje:
La lámpara llegó hoy, pero la pantalla está agrietada. Por favor, envíenme un reemplazo.
Un desarrollador proporciona ese mensaje como state y define tres preguntas. Los resultados a continuación son ilustraciones inventadas, no salidas de una llamada real al modelo:
| Pregunta predefinida | Resultado ilustrativo | Cómo lo usa el código |
|---|---|---|
| Choice: ¿Es esta una solicitud de reemplazo, una consulta sobre envío, una pregunta previa a la venta u otra cosa? | Reemplazo 92%, envío 3%, preventa 1%, otro 4%; seleccionar “reemplazo” | Enviar a la cola de soporte de reemplazos según las reglas de la aplicación |
| Noul: ¿El cliente solicita explícitamente un reemplazo? | 0,98, o una probabilidad estimada del 98% de “sí” | Etiquetar el ticket como una solicitud explícita de reemplazo |
| Score: ¿El tono es tranquilo, moderadamente insatisfecho o muy insatisfecho? | Un puntuación cercano a “moderadamente insatisfecho” | Dar a la persona del soporte una señal adicional para revisar |
Piénsalo como un formulario de clasificación: una persona define las preguntas y las opciones, Jev evalúa el mensaje y el código decide a dónde va. Si el mensaje es ambiguo y las probabilidades están repartidas entre varias opciones, la aplicación puede enviarlo para revisión en su lugar.
La cifra del 98% se refiere a la probabilidad de una solicitud explícita de reemplazo. No significa que el cliente esté “98% insatisfecho”. Tampoco implica que el modelo haya completado un intercambio: verificar el pedido y la política, redactar una respuesta y organizar un reemplazo requieren otras herramientas, un modelo generativo o un agente de soporte.
Asigna roles específicos a la generación, la evaluación y la ejecución
Consideremos un flujo de trabajo para seleccionar el título de un artículo:
- Un modelo generativo elabora diez opciones a partir del material de origen.
- Jev las evalúa según criterios fijos como la claridad, la especificidad y si la fuente respalda sus afirmaciones.
- El código agrega los resultados y presenta los candidatos junto con sus puntuaciones al autor.
El modelo generativo propone opciones, Jev evalúa el significado y el código se encarga de los cálculos y la ejecución. Una Skill describe todo el proceso: las entradas necesarias, las llamadas a las herramientas, cómo manejar la incertidumbre y qué entregar.
Esta división también hace que la depuración sea más específica. Los títulos débiles apuntan a las instrucciones de generación. Un ranking poco útil sugiere revisar más detenidamente los criterios. Totales incorrectos requieren comprobar el código de agregación.
Los proyectos de la comunidad ya ofrecen varios ejemplos interesantes. Los cinco siguientes incluyen herramientas con un archivo SKILL.md, así como aplicaciones y bibliotecas. Los ejemplos de aplicaciones necesitan integrarse adicionalmente antes de que un Agent pueda utilizarlos como Skills.
1. Creación musical: elige los parámetros y luego genera las notas
Jev Playground divide la creación musical en elecciones predefinidas: estado de ánimo, estructura, tonalidad, compás, tempo, instrumentación y frases. Jev selecciona esos parámetros y el software los expande a notas, partitura y reproducción, con exportación MIDI disponible.
Esto ofrece a los creadores de Skills un patrón concreto. Un usuario podría describir un propósito, como música de fondo para leer por la noche. Un flujo de trabajo podría traducir esa solicitud en opciones de parámetros, llamar al programa musical existente y entregar la partitura y un archivo MIDI.
Eso sería una posible “Skill de planificación musical”. Sus controles provienen de elecciones explícitas: cambia la configuración del estado de ánimo para modificar la sensación de la música, o ajusta el tempo y la compás para cambiar el ritmo.
El proyecto también incluye un modo sin conexión que utiliza heurísticas y no requiere ninguna clave API. Al probarlo, distingue la salida sin conexión de una llamada real a Jev; escuchar música por sí sola no demuestra que el modelo haya participado.
2. NPCs de juegos: haz que las decisiones de un guardia sean observables
HEIST//ONE es un juego de sigilo en un museo. Los disfraces, las credenciales, la iluminación y el ruido influyen en las decisiones de los guardias. Jev evalúa la amenaza, la sospecha, la intención táctica y los objetivos de atención, mientras que el código gestiona la física, la búsqueda de caminos, las acciones permitidas por las reglas del juego y las condiciones de victoria.
La interfaz puede mostrar la evidencia que recibió un guardia, las probabilidades del modelo y la acción que finalmente se ejecutó.
Cuando un guardia empieza a perseguir repentinamente, el desarrollador puede examinar lo que vio, qué juicio cambió y cómo el programa tradujo ese juicio en comportamiento.
Esto podría convertirse en un flujo de decisión reutilizable para NPCs: toma el estado local que un personaje puede percibir, elige una acción de un conjunto predefinido y deja que el motor del juego valide y ejecute la decisión. Los desarrolladores definen las acciones disponibles y las reglas de ejecución.
El proyecto viene por defecto con un modo guionizado que no requiere ninguna clave API; las llamadas reales al modelo requieren habilitar Jev. Su autor ha proporcionado evidencia de una ejecución respaldada por el modelo, pero una sola ejecución no garantiza la fiabilidad en diferentes escenarios.
3. Revisión de ideas: formula las mismas preguntas a cada propuesta
Kill My Idea transforma la evaluación de ideas de startups en una pequeña aplicación. Le plantea a Jev diez preguntas que cubren ocho dimensiones de puntuación, la categoría de la idea y cuán claramente está expresada. Luego, el código pondera las puntuaciones para recomendar KILL (descartarla), FIX (revisarla) o SHIP (lanzarla).
El énfasis en la puntuación puede variar según si el objetivo es ganar dinero, desarrollar software libre o divertirse.
Esto sugiere una “Skill de comparación de ideas”: toma varias propuestas, evalúalas según las mismas dimensiones y muestra sus diferencias lado a lado. Podría ayudar a los usuarios a identificar qué ideas están claramente expresadas, cuáles dependen de supuestos no probados y cuáles merecen primero un pequeño experimento.
Criterios consistentes facilitan la comparación. Las puntuaciones aún deben contrastarse con la realidad, especialmente si la gente necesita el producto y lo usará o pagará por él. La documentación del proyecto indica que las evaluaciones completadas se archivan en el servidor por defecto, con una opción de exclusión en el formulario.
4. Enrutamiento de Skills: deja espacio para “no se necesita ninguna Skill”
A medida que crece la biblioteca de Skills, elegir la Skill adecuada se vuelve más importante.
Jev Agent Skill Router toma una solicitud del usuario y un catálogo de Skills, y devuelve una Skill seleccionada, una decisión de «no se necesita ninguna Skill» o una solicitud de revisión. El proyecto se encarga del enrutamiento; otro software debe cargar y ejecutar la Skill seleccionada.
Para las personas que mantienen muchas Skills, esta es una distinción útil. Un enrutador debe tener en cuenta tanto los límites de las tareas como la relevancia. Una pregunta conceptual podría no necesitar una Skill dedicada. Varias Skills plausibles podrían requerir una verificación adicional. Una decisión de omitir una Skill no descarta necesariamente el uso de herramientas más adelante.
Un panel que muestre la solicitud, los candidatos, la selección y la incertidumbre podría ayudar a los responsables a detectar descripciones superpuestas, responsabilidades poco claras o desencadenantes demasiado amplios.
Esta es una dirección que vale la pena explorar en un entorno de Apps y Skills como OOMOL. El proyecto de la comunidad aporta la idea; integrar un enrutador completo aún requiere desarrollo y validación.
5. Selección de registros: decidir qué merece un análisis más profundo
Jev Logs añade valor diagnóstico, prioridad y juicios de enrutamiento a los registros. Ayuda a seleccionar qué registros merecen un análisis más detallado por parte de un modelo más grande, al tiempo que preserva el archivo original. El proyecto proporciona tanto un paquete npm como un archivo SKILL.md. Se encarga del filtrado y el enrutamiento; el análisis de la causa raíz corresponde al flujo de trabajo posterior.
Este patrón se adapta a trabajos recurrentes de selección: identificar el material que necesita atención y luego llamar a un modelo capaz de realizar un análisis más profundo.
Conservar la evidencia es importante. Los registros archivados permiten comprobar si el paso de selección omitió algo útil. Cualquier ahorro de costos depende de la distribución real de los registros, de los errores de filtrado y de cómo se llaman los modelos posteriores.
Empieza con una Skill de revisión de títulos
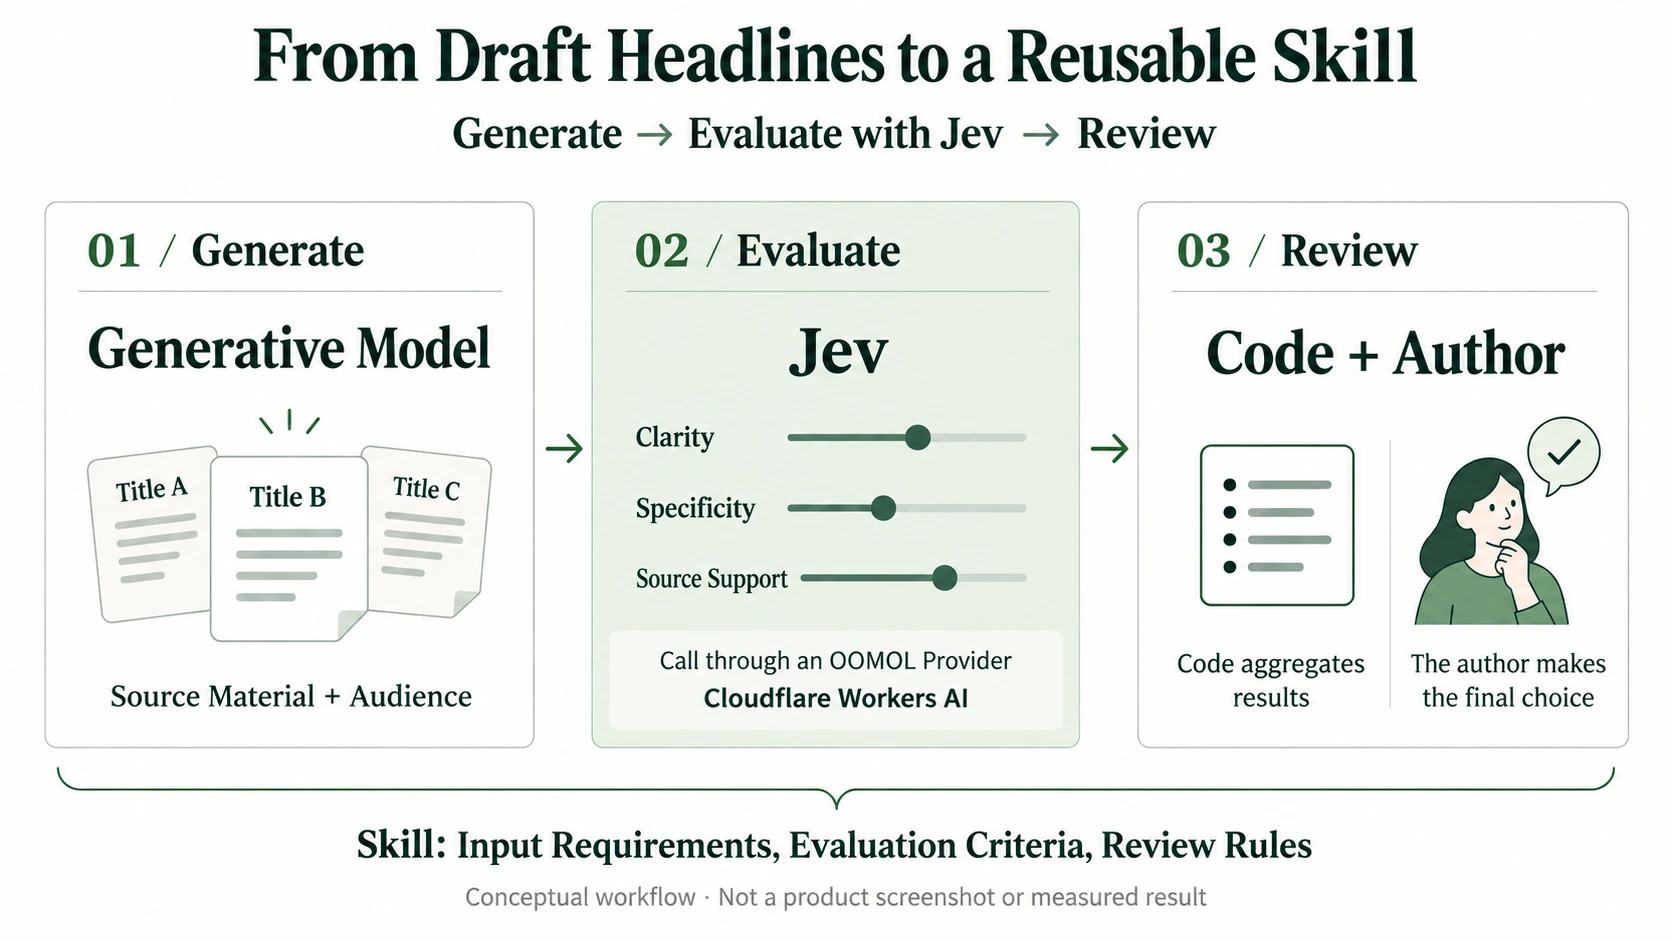
Figura 1: La generación, la evaluación y la revisión tienen roles separados. Esta es una ilustración conceptual, no una captura de pantalla del producto ni un resultado medido.
Para poner estas ideas en práctica, empieza con una tarea acotada cuyos resultados sean fáciles de inspeccionar, como la revisión de títulos.
Puedes definir la tarea de esta manera:
Evaluar diez títulos candidatos en función del material fuente original. Analizar la claridad, la especificidad y si cada título hace promesas que la fuente no respalda. Conservar los juicios individuales y marcar los candidatos para su revisión humana. El autor tomará la decisión final.
Luego, haz explícitas las expectativas del flujo de trabajo:
| Requisito | Ejemplo de revisión de títulos |
|---|---|
| Entradas | Material fuente, público objetivo y títulos candidatos |
| Criterios de evaluación | ¿Es claro el tema? ¿Es específica la redacción? ¿Respalda la fuente la promesa? |
| Uso de los resultados | Ayudar en la comparación y la revisión, conservando cada dimensión |
| Excepciones | Pedir al autor que revise la evidencia faltante o los juicios inciertos |
| Validación | Revisar ejemplos reales, incluidos títulos eficaces, poco claros y ambiguos |
Haz funcionar este pequeño flujo de trabajo antes de ampliarlo a lotes más grandes o a más herramientas. En particular, para contenido en chino, TypeSafe afirma que Jev rinde mejor en inglés; otros idiomas requieren pruebas con tus propios ejemplos. Compatibilidad con modelos e idiomas
Conecta el Provider en OOMOL y empieza a usar Jev
OOMOL ahora ofrece un Provider de Cloudflare Workers AI con soporte para Jev. Conéctalo para empezar a utilizar el modelo. TypeSafe desarrolla Jev, Cloudflare le da acceso a él y OOMOL pone ese acceso a disposición dentro del flujo de herramientas de un Agent. Cloudflare incluye a Jev en su catálogo de modelos.
Empieza con la tarea de revisión de títulos mencionada anteriormente:
- Completa la configuración de conexión del Provider de Cloudflare Workers AI en la Consola de OOMOL.
- Prepara el material fuente y los títulos candidatos. Indica a tu Agent qué dimensiones debe comparar y pídele explícitamente que llame a Jev.
- Revisa los juicios devueltos, identifica los candidatos que necesitan revisión o un examen más detenido y decide qué hacer a continuación.
Una vez conectado, puedes darle a tu Agent una solicitud como esta:
Utiliza el Provider de Cloudflare Workers AI conectado para llamar a Jev y evaluar los siguientes diez títulos. Usando el material fuente original, evalúa la claridad, la especificidad y si algún título hace una promesa no respaldada. Presenta los resultados en una tabla de comparación, conserva cada juicio y enumera los títulos que debería revisar por separado.
El Agent transforma la tarea en preguntas que Jev puede responder, luego organiza los resultados devueltos en una tabla y en texto explicativo. Jev se encarga de los juicios dentro de ese proceso.
Una vez que el flujo de trabajo funcione, guarda los requisitos de entrada, los criterios de evaluación, las llamadas a las herramientas y las reglas de revisión como una Skill de revisión de títulos. Puedes reutilizar el mismo proceso con el siguiente lote de material. La comparación de propuestas, la clasificación de contenidos y la selección de registros son otros posibles puntos de partida.
El Provider te da acceso al modelo; la Skill conserva el método para completar una tarea. Los proyectos de música, juegos y enrutamiento de este artículo ofrecen referencias de diseño. Reproducir su comportamiento completo sigue requiriendo el código de aplicación y la lógica de ejecución correspondientes.
Para obtener orientación sobre el diseño de preguntas de juicio, consulta la Skill oficial de TypeSafe. Los desarrolladores que estén considerando otra integración con MCP también pueden revisar el proyecto comunitario jev-mcp.
Las buenas decisiones requieren preguntas claras y resultados verificables
Jev facilita la inclusión de clasificación, puntuación y selección en el software. Sin embargo, los desarrolladores aún deben definir los candidatos, los criterios de evaluación y qué sucede cuando una elección es incorrecta.
TypeSafe documenta las limitaciones relacionadas con el conteo, las matemáticas, las comparaciones de fechas y el razonamiento indirecto complejo. Los cálculos explícitos deben realizarse en el código, y aun así es necesario verificar la corrección de una salida correctamente estructurada. Limitaciones conocidas del modelo
Estos proyectos sugieren un enfoque concreto de desarrollo: identifica una decisión recurrente en tu flujo de trabajo, proporciona suficiente contexto, define criterios que puedas probar y vincula el resultado con la siguiente acción.
Empieza eligiendo un título, redirigiendo a una Skill o decidiendo si un registro necesita una investigación más profunda. Al conectar entradas, juicios, ejecución y revisión, creas una capacidad que podrás reutilizar.
Empieza en el chat con un Agent de Leina
Para probar lo que puede hacer un Agent, empieza con Agent Leina. Crea y ejecuta un Agent, chatea con él, explora modelos conversacionales como GPT y añade herramientas según lo requieran tus tareas. Los modelos disponibles dependen de las opciones de configuración actuales de Leina.
Leina admite plataformas de mensajería comunes, incluidas Discord, Slack, Microsoft Teams, WeChat, Feishu y DingTalk. Una vez conectado el canal elegido, podrás enviar tareas desde la aplicación de mensajería que ya utilizas en tu teléfono o computadora, sin necesidad de desplegar una puerta de enlace ni escribir llamadas a la API por tu cuenta.
Empieza en tres pasos:
- Crea un Agent. Visita leina.ai, sigue las indicaciones para empezar y crea y ejecuta tu Leina Agent.
- Conecta tu aplicación de mensajería. Sigue las instrucciones de configuración para la plataforma que hayas elegido y luego envía tu primer mensaje desde tu teléfono o computadora.
- Prueba una tarea sencilla. Pídele que explique un concepto, organice el texto que le proporciones o redacte algunos títulos. Añade y autoriza el Connector correspondiente cuando una tarea necesite acceder a otra aplicación.
Por ejemplo, envíale esta solicitud:
Explica Jev con un ejemplo cotidiano y luego redacta cinco títulos a partir del material fuente que se indica a continuación.
A medida que tus tareas vayan aumentando, configura los Connectors que tu Agent necesite. Estas conexiones de aplicaciones le permiten acceder a otros servicios dentro de los permisos que le otorgues y continuar el trabajo iniciado mediante una solicitud en el chat. Puedes elegir diferentes Connectors según tus necesidades y guardar un proceso funcional como una Skill para utilizarlo nuevamente.
Para probar el flujo de trabajo de evaluación de Jev descrito en este artículo, configura una conexión con el Provider de Cloudflare Workers AI que admita Jev para tu Agent y luego envía la solicitud de revisión de títulos mencionada anteriormente. El modelo conversacional maneja el chat ordinario y la generación de títulos; una llamada explícita a Jev te permite probar sus capacidades de clasificación, puntuación y selección.
Visita Leina y crea tu Agent, comenzando con un solo mensaje. Si ya tienes un Agent, también puedes conectar el Provider a través de la Consola de OOMOL y mantener tu configuración existente.
Fuentes y alcance: Este artículo se basa en investigaciones realizadas el 18 de septiembre de 2026, en las que se revisaron por separado la introducción de TypeSafe, la documentación del modelo y sus limitaciones. Las descripciones de los proyectos comunitarios provienen de la documentación del autor examinada durante dicha investigación; las demostraciones y el rendimiento no fueron probados de forma independiente para este artículo. La disponibilidad del Provider y la incorporación y el soporte de canales en Leina se describen utilizando información del equipo de producto y el sitio web de Leina; este artículo no recoge una prueba en vivo de dicho Provider. Las aplicaciones comunitarias y las extensiones de Skill propuestas son distintas de las aplicaciones completas lanzadas por OOMOL.