

 Leina
 Wanta
讓 AI 學會做選擇:Jev 帶來的 5 個 Agent Skill 靈感
從音樂創作、遊戲 NPC 到 Skill 路由,探索 Jev 的 5 個應用靈感,並透過 OOMOL 新增的 Cloudflare Workers AI Provider,將 Jev 判斷能力接入自己的 Agent 工作流程。
OOMOL
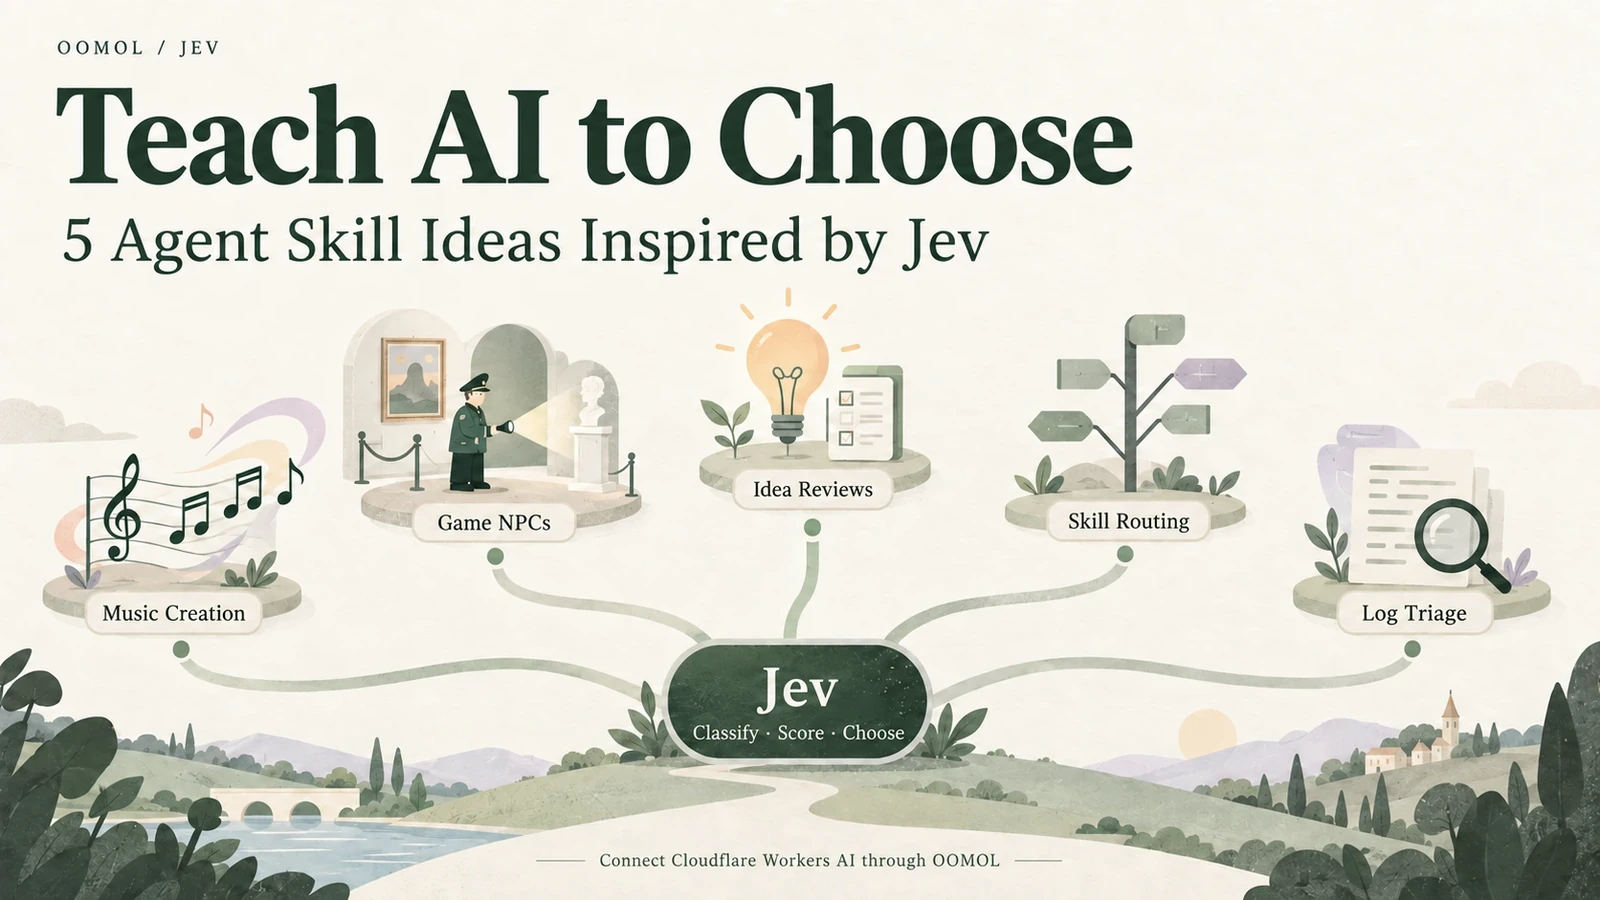
寫出十個標題之後,哪個值得留下?裝了幾十個 Skill 之後,這次任務該呼叫誰?遊戲裡的守衛看到一個可疑的人,應該繼續巡邏、上前盤問,還是拉響警報?
這些任務的輸出可能只有一個選項,但要選得合適,往往需要理解上下文。
TypeSafe 於 2026 年 9 月 15 日推出 Jev 的搶先體驗版本,專門用於這類判斷任務:接收文字或結構化狀態,根據預先定義的問題型別,回傳選項或評分,以及相應的機率資訊。開發者可以把這些結果接入程式,決定下一步怎麼走。官方介紹
Jev 目前接收文字輸入。圖片、音訊和影片需要先轉換為文字描述或結構化欄位,再交給它判斷。輸入要求
對關注 Agent 和 Skills 的 OOMOL 讀者來說,Jev 帶來的一個值得嘗試的方向是:找出工作流程中反覆出現的判斷,寫清標準,再把判斷與後續動作組織成可重複使用的 Skill。
OOMOL 已新增支援 Jev 的 Cloudflare Workers AI Provider。完成連線後,就可以在自己的 Agent 工作流程中呼叫 Jev,把以下這些思路用到具體任務裡。
Jev 的基本原理:把語義判斷變成程式可用的結果
從公開的技術說明來看,Jev 是一種面向結構化決策的模型,TypeSafe 將這類模型稱為 System One 模型。一次請求包含兩部分:state 提供待判斷的內容和背景,questions 定義要問的問題、答案型別與判斷標準。模型回傳帶型別約束的結果,程式可以直接用它做分支、排序或路由。官方技術概述
它提供三種基本判斷型別:
| 型別 | 解決什麼問題 | 回傳什麼 |
|---|---|---|
| Choice:選擇 | 從預設選項中選一個,例如給訊息分類 | 選中的選項、各選項的機率分布,以及信心度 |
| Score:評分 | 根據事先定義的有序等級評估程度 | 評分、各等級的機率分布,以及信心度;評分可以落在兩個等級之間 |
| Noul:真假判斷 | 判斷一個明確陳述是否成立 | 0 到 1 之間的「是」的機率,不附帶單獨的信心度欄位 |
這些問題可以放進同一次請求,圍繞同一份 state 獨立、平行地評估。同一次請求中的問題不會讀取彼此的答案;如果後一個判斷確實依賴前一個結果,就由程式拿到結果後再發起下一次請求。問題類型與組合方式
生成式語言模型通常逐個 token 生成回答文字。根據 TypeSafe 的說明,Jev 針對這些受限的輸出採用平行取樣,直接輸出判斷與機率,省去了生成自由文字答案的過程。它的訓練方法稱為 RLCD(Reinforcement Learning for Calibrated Decisions,面向校準決策的強化學習),目標包括讓輸出機率更貼近實際發生頻率。模型設計 · RLCD 說明
「機率校準」可以這樣理解:在足夠多、相似的判斷中,被賦予 80% 機率的事件,理想情況下應當大約有 80% 真正發生。這是統計意義上的目標,不能保證某一次回答正確。Choice 和 Score 的 confidence 則由機率分布計算得到,用來概括結果有多集中,不能直接當成「這次回答正確的機率」。是否自動執行、補充資訊或交給人工覆核,仍由程式規則決定,並需要用實際資料驗證。機率與信心度
一個簡單例子:把一條售後訊息分到正確的位置
假設一家網店收到訊息:
今天收到的檯燈,燈罩裂了,請幫我換一個。
開發者把這條訊息作為 state,並提前定義三個問題。下面是為了說明流程而編寫的結果示例,並非實際呼叫回傳值:
| 提前定義的問題 | 示例結果 | 程式怎樣使用 |
|---|---|---|
| Choice:屬於「售後換貨、物流查詢、售前諮詢、其他」中的哪一類? | 售後換貨 92%、物流查詢 3%、售前諮詢 1%、其他 4%;選擇「售後換貨」 | 根據路由規則,送入換貨工單佇列 |
| Noul:客戶是否明確要求換貨? | 0.98,即模型估計「是」的機率為 98% | 給工單新增「明確提出換貨」的標記 |
| Score:語氣屬於「平靜、中等不滿、強烈不滿」中的什麼程度? | 評分接近「中等不滿」等級 | 作為客服檢視工單時的參考資訊 |
這個過程像一張事先設計好的分類表:人定義問題和選項,Jev 根據訊息做判斷,程式決定分到哪裡。 如果訊息太含糊,各選項的機率接近,程式也可以將它轉入待覆核佇列。
這裡的 98% 表示「明確要求換貨」這一判斷為「是」的機率,不表示客戶有「98% 的不滿」。模型也沒有完成換貨:查訂單、核對規則、生成回覆和實際處理,需要由其他工具、生成模型或客服繼續完成。
生成、判斷、執行,可以各有分工
以挑選文章標題為例,一條工作流程可以這樣拆開:
- 生成模型根據素材寫出十個候選標題。
- Jev 按清楚程度、具體程度,以及承諾是否有素材依據等固定標準評估。
- 程式碼彙總結果,把候選標題和評分交給作者選擇。
生成模型負責提出候選,Jev 負責語義判斷,程式碼負責計算與執行。Skill 則描述這套流程:需要什麼輸入、如何呼叫工具、遇到不確定結果怎麼辦,以及最終交付什麼。
這種分工也讓除錯更具體。標題不好,可以檢查生成要求;排序不合理,可以調整評判標準;結果算錯了,就檢查彙總邏輯。
社群已經出現了一些很有意思的探索。下面五個專案分別展示了這種分工可以走向哪裡。其中既有附帶 SKILL.md 的工具,也有應用和程式碼庫;應用案例需要額外封裝,才能成為 Agent 可直接使用的 Skill。
1. 音樂創作:讓模型選擇音樂參數,讓程式生成音符
Jev Playground 將音樂創作拆成一組有限選擇:曲子的情緒基調、結構、調性、節拍、速度、音色與樂句。Jev 選擇這些參數,程式再將它們展開為音符、樂譜和播放結果,並支援 MIDI 匯出。
這個設計給 Skill 開發提供了一個直觀例子。使用者可以先描述用途,比如「一段適合夜晚讀書的背景音樂」,工作流程再將描述轉成參數選擇,呼叫已有的音樂程式,交付樂譜和 MIDI。
這是一種可以繼續封裝的「音樂方案 Skill」。它的可控性來自明確的選項:想調整音樂情緒,可以修改對應參數;想改變節奏,可以改速度與節拍。
專案也提供無需 API Key 的離線模式,使用啟發式邏輯。體驗時要區分離線結果和真實 Jev 呼叫;聽到音樂本身,並不能證明模型參與了創作。
2. 遊戲 NPC:把守衛的判斷過程展示出來
HEIST//ONE 是一個博物館潛行遊戲。玩家透過偽裝、證件、燈光和噪聲影響守衛的判斷;Jev 評估威脅、可疑程度、戰術意圖和關注目標,程式碼處理物理、尋路、遊戲規則允許的動作與勝負。
有意思的地方在於,介面能展示守衛收到的證據、模型給出的機率,以及最終執行的行為。
當守衛突然追過來時,開發者可以觀察:它看到了什麼?哪個判斷髮生了變化?程式怎樣把判斷轉成行動?
這種方式可以進一步做成可重複使用的 NPC 決策流程:輸入角色能感知到的區域性狀態,從預設動作中選擇一個,再由遊戲引擎檢查和執行。角色的可選動作與執行規則都由開發者定義。
專案預設使用無需 API Key 的指令碼模式;啟用 Jev 後才會實際呼叫模型。作者提供了真實呼叫的執行記錄,但單次執行記錄不足以說明它在不同場景中的穩定性。
3. 點子評審:讓幾個方案接受同一套提問
Kill My Idea 把創業點子評估做成了一個小工具:向 Jev 提出十個問題,包括八個評分維度,以及對點子類別和表述清晰程度的判斷,再由程式加權得出 KILL(放棄)、FIX(修改)或 SHIP(推出)的建議。
它還會根據賺錢、開放原始碼或純好玩等目標,調整評分重點。
這個專案可以啟發一種「方案對比 Skill」:一次輸入多個點子,使用相同的維度評估,再把差異並排展示。使用者能更容易看見,哪些方案表達清楚,哪些依賴尚未驗證的假設,哪些值得先做一個小實驗。
固定標準有助於比較。評分仍需要接受現實檢驗,尤其要驗證目標使用者是否有需求、是否願意使用或付費。專案說明還提到,成功完成的評估預設會在服務端歸檔,表單提供不參與歸檔的選項。
4. Skill 路由:給 Agent 留下「無需 Skill」的選項
Skill 越多,選擇就越重要。
Jev Agent Skill Router 接收使用者請求與 Skill 目錄,回傳三類結果之一:選擇某個 Skill、無需 Skill,或需要覆核。專案本身負責路由,後續載入和執行要由其他程式完成。
這對維護大量 Skills 的人很有啟發。路由器除了要回答「哪個最相關」,還需要處理任務邊界:使用者只是問一個概念,可能無需專門的 Skill;多個 Skill 都看起來合適,則需要進一步檢查。無需 Skill,也不等於後續一定不會呼叫工具。
如果把這個過程做成一個可觀察的面板,展示請求、候選項、選擇結果與不確定性,就能幫助維護者發現描述過於相似、職責交叉或觸發範圍過寬的 Skill。
對於 OOMOL 這樣的 Apps 與 Skills 使用場景,這是一個值得探索的設計方向。這裡討論的是社群專案帶來的啟發,具體接入仍需開發與驗證。
5. 日誌篩選:先判斷哪些值得繼續分析
Jev Logs 為日誌新增診斷價值、優先順序和路由判斷,幫助選擇哪些日誌值得交給大模型繼續分析,同時保留原始歸檔鏈路。專案同時提供 npm 包與 SKILL.md,負責篩選和路由,根因分析由後續流程完成。
這類流程適合用來處理重複出現的初篩任務:先識別需要進一步關注的內容,再呼叫分析能力更強的模型。
這裡的關鍵是保留複查依據。被跳過的日誌仍然歸檔,後續才能檢查是否漏掉了有價值的線索。能節省多少成本,要看實際日誌分佈、篩選錯誤,以及下游模型的呼叫方式。
從一個「標題評審 Skill」開始
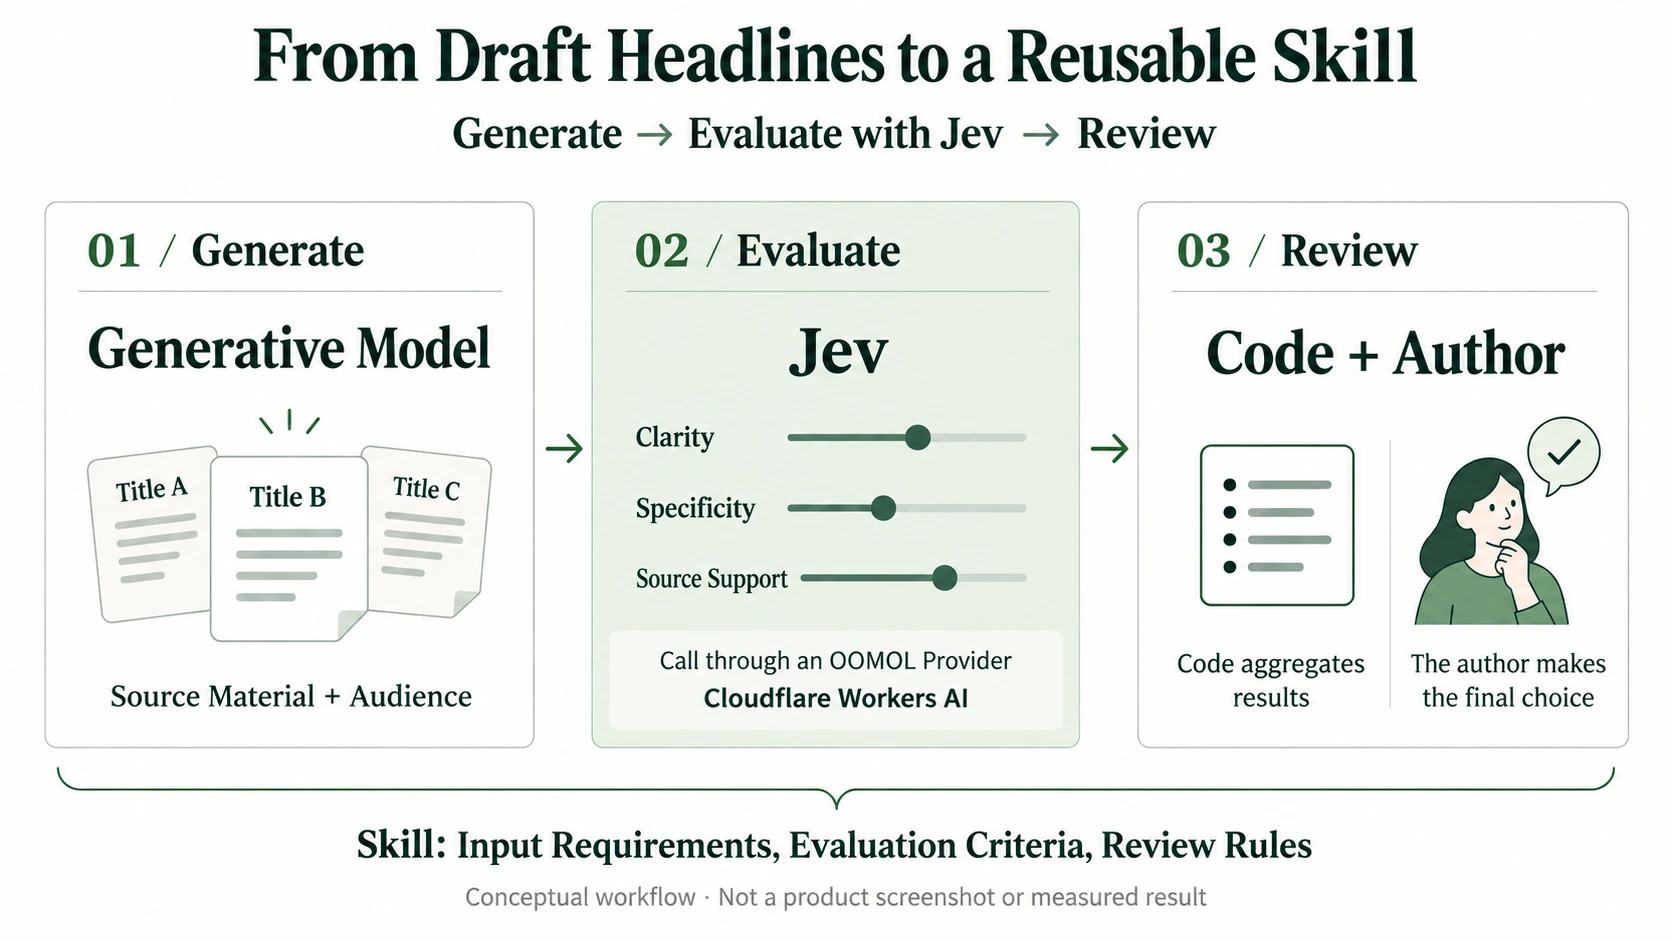
圖 1:以標題評審為例,生成、判斷與覆核各有分工;圖示為概念說明,非產品介面或實測結果。
如果要把這些想法運用在日常工作,我們建議先嘗試一個範圍明確、輸出容易檢查的任務,比如標題評審。
可以先寫下這樣的任務要求:
根據原始素材,評估十個候選標題的清楚程度、具體程度,以及是否包含素材無法佐證的承諾。保留各項結果,列出值得人工覆核的標題,由作者決定最終採用哪一個。
接下來,把流程中的幾個約定寫清楚:
| 約定 | 標題評審中的例子 |
|---|---|
| 輸入 | 原始素材、目標讀者、候選標題 |
| 判斷標準 | 能否看出主題,是否具體,承諾是否有素材依據 |
| 結果用途 | 幫助比較和覆核,保留各維度結果 |
| 例外處理 | 素材不足或判斷不確定時,交給作者檢查 |
| 驗證方法 | 用包含好標題、差標題和模糊案例的真實樣本檢查結果 |
先跑通這一小段流程,再考慮批次處理和更多工具。尤其是中文內容,官方說明 Jev 目前在英文上的準確性最好,其他語言需要用自己的樣本驗證。模型與語言支援
在 OOMOL 中連線 Provider,開始使用 Jev
OOMOL 已新增支援 Jev 的 Cloudflare Workers AI Provider,接上就可以使用。 Jev 由 TypeSafe 開發,Cloudflare 提供模型存取入口,OOMOL 則把這個入口接入 Agent 的工具使用流程。Cloudflare 的模型目錄已列出 Jev。
可以從前面的標題評審開始:
- 在 OOMOL 控制台中,完成 Cloudflare Workers AI Provider 的連線設定。
- 準備原始素材和候選標題,告訴 Agent 要比較哪些維度,並明確要求呼叫 Jev。
- 檢視回傳的判斷,將需要修改或人工覆核的標題挑出來,再決定下一步。
例如,連線完成後,可以把下面這段任務交給 Agent:
使用已連線的 Cloudflare Workers AI Provider 呼叫 Jev,評估下面十個標題。請結合原始素材,分別判斷標題是否清楚、是否具體,以及是否包含素材無法佐證的承諾。整理成對比表,保留各項判斷,把需要我覆核的標題單獨列出。
Agent 會先將任務拆成 Jev 支援的判斷問題,再將回傳結果整理成表格和文字說明。Jev 在其中負責判斷。
跑通之後,可以把輸入要求、評判標準、呼叫步驟和覆核規則整理成一個標題評審 Skill。下次換一批素材,繼續沿用同一套流程。類似地,也可以從候選方案比較、內容分類或日誌初篩開始。
Provider 提供模型呼叫入口,Skill 儲存完成任務的方法。 本文中的音樂、遊戲和路由專案提供了設計參考;要重複使用它們的完整玩法,仍需接入相應程式和執行邏輯。
需要進一步設計判斷問題時,可以參考 TypeSafe 官方 Skill。使用其他 MCP 接入方式的開發者,也可以檢視社群的 jev-mcp。
好的判斷,需要清楚的問題和可檢查的結果
Jev 讓分類、評分和選擇更容易成為程式的一部分。使用時,仍然需要定義候選項、判斷標準,以及選錯之後如何處理。
官方也列出了計數、數學、日期比較與複雜間接推理等限制。因此,明確的計算應交給程式碼;結構正確的輸出,也需要檢查判斷是否符合實際。已知能力限制
從這些專案中,OOMOL 讀者可以帶走一個具體的開發方向:找到工作流程裡那個反覆出現的選擇,為它準備足夠的上下文,寫出可以驗證的標準,再將結果連結到下一步動作。
可以從挑一個標題、選一個 Skill,或決定一條日誌是否需要深入分析開始。把輸入、判斷、執行和覆核連起來,才構成一項能夠重複使用的能力。
用 Leina Agent,在聊天裡開始體驗
如果你想先體驗 Agent 能做什麼,可以從 Leina Agent 開始。建立並執行一個 Agent,就可以先和它聊天、體驗 GPT 等模型的對話能力,再按自己的任務逐步新增工具。可選模型以 Leina 目前提供的設定為準。
Leina 可以接入 Discord、Slack、Microsoft Teams、微信(WeChat)、飛書和釘釘等常見聊天工具。完成對應聊天管道的串接後,在手機或電腦上開啟你平時使用的聊天應用,就能把任務交給 Agent,無需先自己部署閘道或編寫 API 呼叫程式碼。
可以按下面三步開始:
- 建立 Agent:開啟 leina.ai,從開始使用入口進入,建立並執行自己的 Leina Agent。
- 接入常用聊天工具:按所選平臺的接入說明完成設定,在手機或電腦上發出第一條訊息。
- 從一個小任務開始:先讓它解釋概念、整理你發來的文字或提出幾個標題;需要存取其他應用時,再新增相應的 Connector 並完成授權。
例如,你可以直接發給它:
用一個生活中的例子解釋 Jev,然後根據下面這段素材,幫我寫五個標題。
有了具體任務,再給 Agent 設定所需的 Connector(應用連接器)。它們讓 Agent 能在授權範圍內存取其他服務,把聊天中的需求繼續落實為工作。你可以根據自己的需要設定不同的 Connector,也可以把跑通的步驟整理成 Skill,留給下次使用。
想進一步體驗本文的 Jev 判斷流程,就為 Agent 設定支援 Jev 的 Cloudflare Workers AI Provider 連線,再傳送前面的標題評審要求。日常聊天和生成標題由對話模型完成;明確呼叫 Jev 後,才是在體驗它的分類、評分與選擇能力。
前往 Leina,建立你的 Agent,先從一條訊息開始。如果已經有自己的 Agent,也可以繼續透過 OOMOL 控制台連線 Provider,沿用現有的工作方式。
資料說明:本文基於 2026 年 9 月 18 日的 Jev 調研報告整理,並覆核了 TypeSafe 官方介紹、模型文件與能力限制。社群專案描述來自報告所核驗的作者說明;本文未重現社群示範或進行效能測試。OOMOL 新增 Provider 及 Leina 體驗入口、管道支援的資訊結合產品團隊說明與 Leina 官網整理;本文未進行該 Provider 的實際呼叫測試。文中的社群應用與 Skill 延伸方案不等同於 OOMOL 已上線的完整應用。