

 Leina
 Wanta
AIに選択を任せる:Jevから生まれる5つのAgent Skillのアイデア
音楽制作、ゲームのNPC、Skillの振り分けなど、Jevの5つの活用例を紹介。OOMOLのCloudflare Workers AI Providerで判断機能を組み込み、Leina Agentのチャットから体験を始められます。
OOMOL
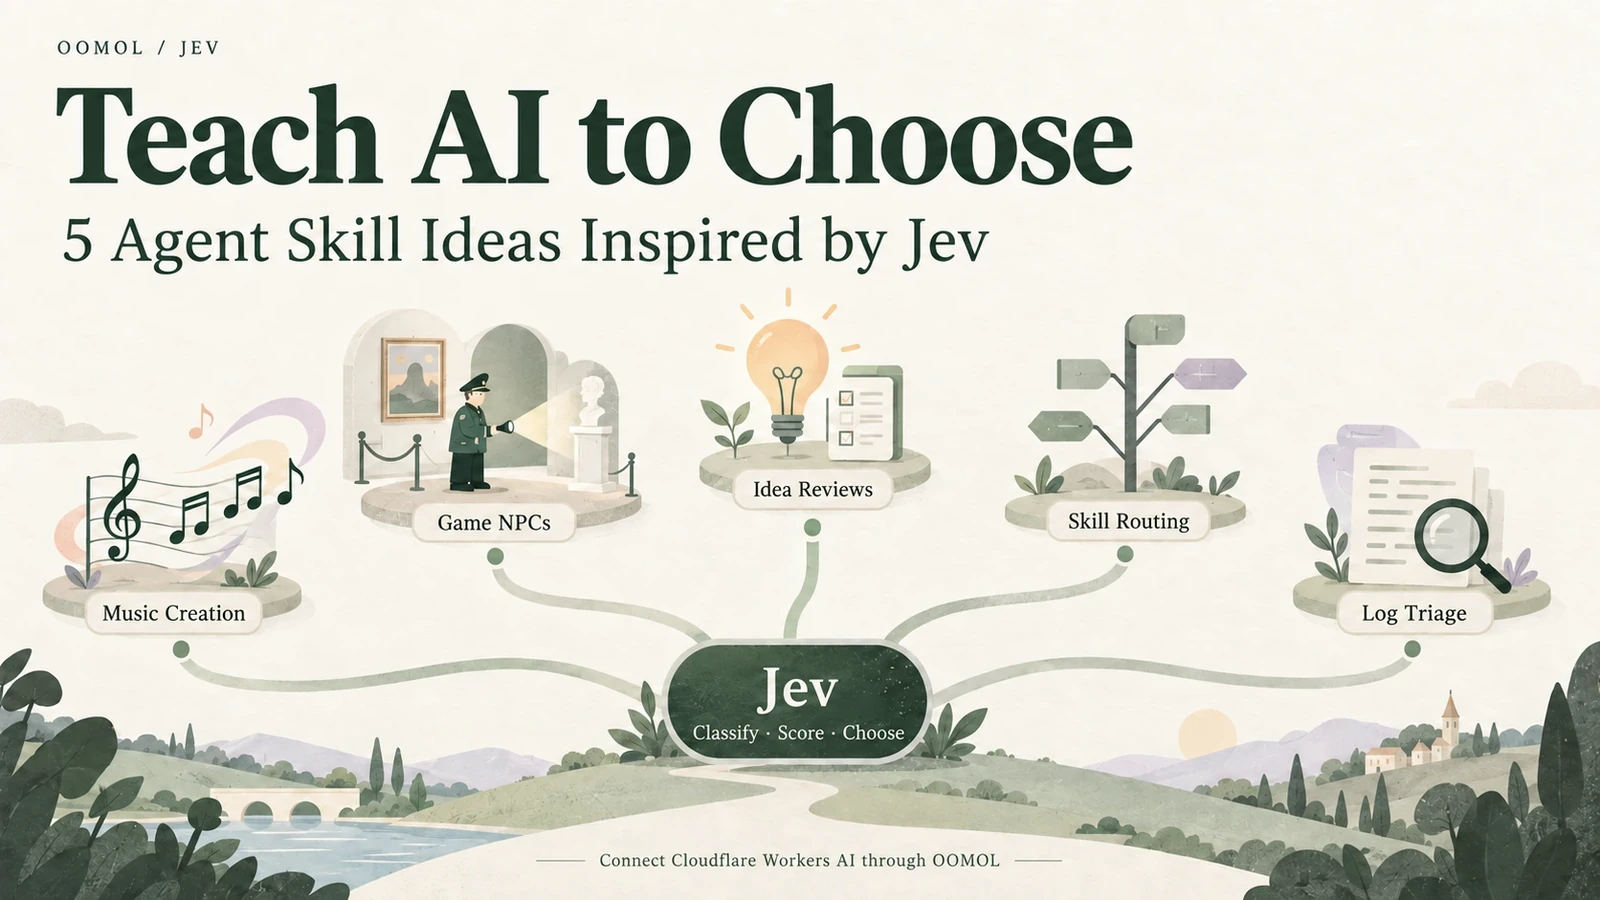
10個の見出し案があります。どれを採用すべきでしょうか? 数十ものSkillを導入しましたが、次のリクエストにはどれが適しているのでしょうか? ゲーム内の警備員が不審者を発見しました。そのまま巡回を続けるべきか、声をかけるべきか、それとも警報を鳴らすべきでしょうか?
各タスクの結果は選択肢一つだけかもしれませんが、その選択を行うためには文脈を理解する必要があります。
2026年9月15日にTypeSafeによって早期アクセス版として公開されたJevは、こうした意思決定のために設計されています。テキストまたは構造化された状態を入力として受け取り、あらかじめ定義された質問タイプに従って選択肢やスコア、さらに確率情報を返します。開発者はこれらの結果をもとに、ソフトウェアの次の一歩を決定できます。TypeSafeによる紹介
Jevは現在、テキスト入力をサポートしています。画像、音声、動画は、評価のためにまずテキストによる説明や構造化フィールドに変換する必要があります。入力要件
AgentとSkillを扱うOOMOLの読者にとって、これは有用なアプローチを示唆しています:ワークフローの中で繰り返される判断を特定し、その基準を定義して、意思決定とその後の処理を再利用可能なSkillとしてパッケージ化することです。
OOMOLでは、Jevに対応したCloudflare Workers AI Providerを提供しています。接続すれば、AgentワークフローからJevを呼び出し、以下のアイデアを実際のタスクに適用し始めることができます。
Jevの仕組み:意味的な判断をソフトウェアが利用できる結果へ変換する
Jevは構造化された意思決定向けに設計されています。TypeSafeはこの種のモデルを「System Oneモデル」と呼んでいます。リクエストには、評価に必要な材料と文脈を含むstateと、判断内容・回答タイプ・基準を定めるquestionsが与えられます。モデルは、コードが分岐・ランキング・ルーティングに利用できる型付きの結果を返します。技術概要
基本的な質問タイプは3種類あります:
| タイプ | 目的 | 出力 |
|---|---|---|
| Choice | 事前に定義されたオプションの中から一つを選択(例:メッセージカテゴリ) | 選択されたオプション、確率分布、信頼度 |
| Score | 事前に定義された順序付けられたレベルに対して程度を評価 | スコア、レベルごとの分布、信頼度;スコアはレベル間の値を取り得る |
| Noul | 特定の記述が真であるかどうかを判断 | 「はい」の確率(0~1)、別途の信頼度フィールドなし |
一つのリクエスト内で複数の質問は、同じstateに対して独立かつ並行に評価されます。質問同士は互いの回答を見ません。後の判断で前の結果が必要な場合は、コードが追加のリクエストを送る必要があります。質問タイプと組み合わせ
生成言語モデルは通常、トークン単位で回答を生成します。TypeSafeはJevについて、制約のある出力に対して並列サンプリングを行い、自由形式のテキスト回答を生成せずに意思決定と確率を返すと説明しています。訓練手法は**RLCD(Reinforcement Learning for Calibrated Decisions:確率を校正した判断のための強化学習)**で、予測確率と観測頻度の一致を目指しています。モデル設計 · RLCDの解説
良好にキャリブレーションされたモデルの場合、80%の確率が割り当てられた出来事は、多くの同等の予測において約80%の頻度で発生するはずです。これは統計的な目標であり、個々の回答に対する保証ではありません。ChoiceおよびScoreの回答にあるconfidenceフィールドは、確率分布の集中度を表しており、選択された回答が正しい確率そのものではありません。コードは、実際の事例に基づいて検証されたルールを用いて、行動を起こすタイミングや追加情報の取得、人間によるレビューの依頼などを決定します。確率と信頼度
簡単な例:顧客からのメッセージをルーティングする
オンラインストアに以下のようなメッセージが届いたと想像してください:
ランプは今日届きましたが、シェードにひびが入っています。交換品をお願いします。
開発者がこのメッセージをstateとして提供し、3つの質問を定義した場合、以下の結果が得られると仮定します。なお、以下は架空の例であり、実際のモデル呼び出しの出力ではありません。
| 事前定義された質問 | 例示的な結果 | コードでの活用方法 |
|---|---|---|
| Choice:これは交換依頼か、配送問い合わせか、販売前のお問い合わせか、それともその他か? | 交換92%、配送3%、販売前1%、その他4%;「交換」を選択 | アプリケーションのルールに従い、交換対応のキューへルーティング |
| Noul:顧客は明示的に交換を要求しているか? | 0.98、つまり「はい」の確率は推定98% | チケットに「明示的な交換依頼」というラベルを付ける |
| Score:トーンは穏やかか、やや不満か、あるいは非常に不満か? | 「やや不満」に近いスコア | 対応担当者に追加の確認シグナルを与える |
これを一種の振り分けフォームと考えてください:人が質問と選択肢を定義し、Jevがメッセージを評価し、コードが行き先を決定します。 メッセージが曖昧で確率が複数の選択肢に分散している場合、アプリケーションはそれをレビューに回すこともできます。
98%という数値は、メッセージに明確な交換依頼が含まれるとモデルが判断した確率を指します。これは顧客が「98%不満である」という意味ではありません。また、モデルが交換処理を完了したわけでもありません。注文やポリシーの確認、返信文の作成、交換手配などには、他のツールや生成モデル、あるいはサポート担当者の介入が必要です。
生成・評価・実行にそれぞれの役割を持たせる
記事の見出しを選定するワークフローを考えてみましょう。
- 生成モデルが元の資料から10個の見出し案を作成します。
- Jevが、明瞭さや具体性、元の資料が主張を裏付けているかといった固定基準に基づいてそれらを評価します。
- コードが結果を集計し、候補とスコアを執筆者に提示します。
生成モデルは選択肢を提案し、Jevは意味を評価し、コードは計算や実行を担います。Skillは、全体のプロセスを記述します:必要な入力、ツールの呼び出し、不確実性への対処方法、そして最終的に何を提供するのか。
この役割分担により、デバッグもより具体的になります。弱い見出しがあれば生成指示を見直す必要があります。役に立たないランキングであれば評価基準を精査する必要があります。合計が間違っている場合は集計コードを確認する必要があります。
コミュニティプロジェクトにはすでにいくつかの興味深い例があります。以下の5つは、SKILL.mdファイルを持つツールや、アプリケーション、ライブラリを含んでいます。アプリケーションの例については、AgentがSkillとして利用するためにはさらなる統合が必要です。
1. 音楽制作:パラメータを選択してから音符を生成する
Jev Playground は、音楽制作を事前に定義された選択肢に分解しています:ムード、構成、キー、拍子、テンポ、楽器編成、フレーズなど。Jevがこれらのパラメータを選択し、ソフトウェアがそれを音符や楽譜、再生へと展開し、MIDIエクスポートも可能です。
これにより、Skill構築者には具体的なパターンが与えられます。例えば「夜の読書用のBGM」という要望をパラメータの選択に変換し、既存の音楽プログラムを呼び出して楽譜とMIDIファイルを渡すワークフローを設計できます。
これが「音楽プランニングSkill」の一例となり得ます。その制御は明示的な選択肢によって行われます:ムード設定を変更して音楽の雰囲気を変えたり、テンポや拍子を調整してリズムを変えることができます。
このプロジェクトにはAPIキーを必要としないヒューリスティックを利用するオフラインモードも備わっています。試す際には、オフラインでの出力と本物のJev呼び出しとの違いを区別してください。音楽が鳴っただけでは、モデルが実際に参加したかどうかは判断できません。
2. ゲームのNPC:警備員の意思決定を可視化する
HEIST//ONE は美術館を舞台としたステルスゲームです。変装、身分証明、照明、騒音などが警備員の判断に影響を与えます。Jevは脅威度、疑念、戦術的意図、注意の指向先などを評価し、コードが物理演算、経路探索、ゲームのルール上で許可される行動、勝利条件などを処理します。
インターフェースには、警備員が受け取った証拠やモデルの確率、最終的に実行された行動を表示できます。
警備員が突然追跡を開始した場合、開発者は何が見え、どの判断が変化し、それがどのように行動に反映されたのかを確認できます。
これは再利用可能なNPCの意思決定ワークフローになり得ます:キャラクターが感知できるローカル状態を受け取り、事前に定められた行動セットから一つを選択し、ゲームエンジンがそれを検証・実行する仕組みです。開発者が利用可能な行動と実行ルールを定義します。
プロジェクトはデフォルトでスクリプトモードになっており、APIキーは不要です。本格的なモデル呼び出しを行うにはJevを有効にする必要があります。作者はモデルを利用した実行例を公開していますが、一度の実行だけでは異なるシナリオにおける信頼性を保証するものではありません。
3. アイデアレビュー:すべての提案に同じ質問を投げかける
Kill My Idea は、スタートアップアイデアの評価を小さなアプリケーションに落とし込んだものです。Jevに8つの採点軸、アイデアのカテゴリー、表現の明確さなどに関する10の質問を投げかけ、コードがスコアを重み付けして「KILL(諦める)」「FIX(修正する)」「SHIP(ローンチする)」のいずれかを推奨します。
収益化を目指すのか、オープンソースを作るのか、それとも楽しみたいのかによって採点の比重を変えることができます。
これは「アイデア比較Skill」の可能性を示唆しています:複数の提案を選び、同じ軸で評価し、その差異を並べて表示するのです。どのアイデアが明確に表現されているか、未検証の仮定に依存しているか、まずは小規模な実験が必要かを把握するのに役立ちます。
一貫した基準があれば比較は容易になります。ただし、製品が必要とされ、人々が実際に使用したり支払ったりするのかどうかは、依然として現実と照らし合わせる必要があります。プロジェクトのドキュメントによれば、成功した評価はデフォルトでサーバー上に保存されますが、フォーム上でオプトアウトも可能です。
4. Skillルーティング:「Skill不要」の余地を残す
Skillライブラリが拡充するにつれて、適切なSkillを選ぶ重要性は増します。
Jev Agent Skill Router は、ユーザーからの要求とSkillカタログを受け取り、選択されたSkill、Skill不要の判断、またはレビュー依頼のいずれかを返します。ルーティングはこのプロジェクトが担い、選択されたSkillの読み込みと実行は別のソフトウェアが行う必要があります。
多くのSkillを管理している人にとって、これは有用な区別です。ルーターは、タスクの境界だけでなく関連性も考慮しなければなりません。概念的な質問には専用のSkillが必要ない場合もあります。複数のSkillが適切に見える場合は、追加の確認が必要になることがあります。Skillをスキップするという判断が、後でツールを使用することを必ずしも排除するわけではありません。
リクエスト、候補、選択、および不確実性を示すパネルがあれば、管理者は重複する説明や不明確な責任範囲、あるいは過度に広いトリガーを見つけるのに役立つでしょう。
これは、OOMOLのようなアプリとSkillの環境で検討する価値のある方向性です。アイデアはコミュニティプロジェクトによって提供されていますが、完全なルーターを統合するには依然として開発と検証が必要です。
5. ログのトリアージ:詳しい分析が必要なログを選ぶ
Jev Logs は、ログに診断上の有用性、優先度、振り分け先についての判断を付加します。大規模なモデルによるさらなる分析が必要なログを選定しつつ、元のアーカイブを保持するのに役立ちます。このプロジェクトは npm パッケージと SKILL.md ファイルの両方を提供しており、フィルタリングとルーティングを担います。根本原因の分析は下流のワークフローに委ねられます。
このパターンは、繰り返し行われるトリアージ作業に適しています。注意を要する内容を特定し、その後、より深い分析が可能なモデルを呼び出します。
証拠を残しておくことは重要です。アーカイブされたログがあれば、トリアージ段階で有用な情報を見落としていないか確認できます。コスト削減の効果は、実際のログの分布、フィルタリングの誤り、そして下流のモデルの呼び出し方法に依存します。
見出しレビューのSkillから始めよう
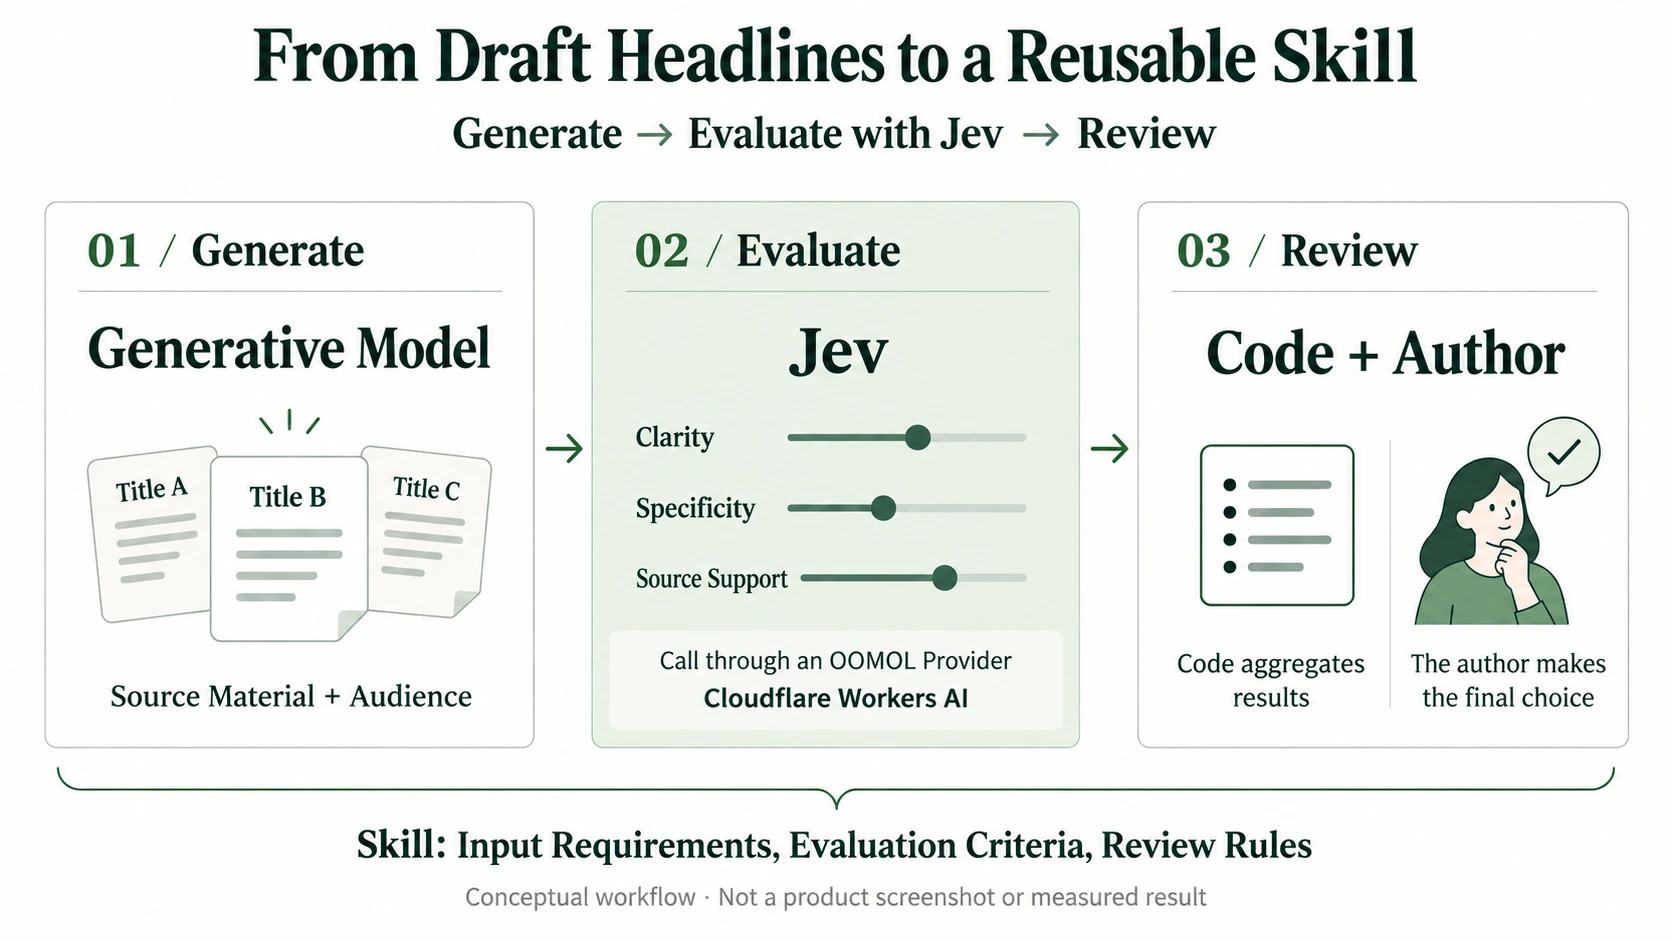
図1:生成、評価、レビューはそれぞれ独立した役割を持ちます。これは概念的な図であり、製品のスクリーンショットや測定結果ではありません。
これらのアイデアを実践するには、結果を容易に確認できるような限定的なタスク、例えば見出しのレビューから始めましょう。
タスクを次のように定義できます:
元の資料に対して候補となる10本の見出しを評価してください。明瞭さ、具体性、および各見出しに元の資料で裏付けられない約束が含まれていないかを判定します。個々の判断を保存し、人間によるレビューが必要な候補にはフラグを立ててください。最終的な選択は執筆者が行います。
次に、ワークフローの条件を明確にします:
| 要件 | 見出しレビューの例 |
|---|---|
| 入力 | 元の資料、対象読者、候補となる見出し |
| 評価基準 | トピックは明確か?表現は具体的か?元の資料にその約束の根拠があるか? |
| 結果の利用 | 各要素を保持しつつ、比較とレビューを支援する |
| 例外 | 情報不足や判断に疑義がある場合は執筆者にレビューを依頼する |
| 検証 | 良い見出し、改善が必要な見出し、判断が難しい見出しを含む実例で確認する |
大きなバッチやより多くのツールへ展開する前に、まずはこの小さなワークフローを機能させましょう。特に中国語コンテンツに関しては、TypeSafe によれば Jev の性能は現時点で英語が最も優れているとのことです。他の言語については、お客様ご自身のサンプルでテストする必要があります。モデルと言語のサポート
OOMOL で Provider を接続し、Jev の使用を開始する
OOMOL では現在、Cloudflare Workers AI Provider を提供しており、Jev に対応しています。これを接続すれば、同モデルの使用を開始できます。 Jev の開発は TypeSafe が行い、Cloudflare がそのアクセスを提供、OOMOL は Agent のツールワークフロー内でそのアクセスを可能にしています。Cloudflare は Jev をモデルカタログに掲載しています。
上記の見出しレビューのタスクから始めましょう:
- OOMOL Console で Cloudflare Workers AI Provider の接続設定を完了します。
- 元の資料と候補となる見出しを準備し、Agent にどの要素を比較すべきか伝え、Jev の呼び出しを明示的に指示します。
- 返却された評価結果を確認し、修正や精査が必要な候補を特定し、次の手順を決定します。
接続後は、Agent に次のようなリクエストを出すことができます:
接続済みの Cloudflare Workers AI Provider を使って Jev を呼び出し、以下の10本の見出しを評価してください。元の元の資料を参照しながら、明瞭さ、具体性、およびどの見出しが根拠のない約束をしているかを判断してください。結果を比較表にまとめ、各評価を保存し、私が個別にレビューすべき見出しをリストアップしてください。
Agent はこのタスクを Jev が対応可能な質問に変換し、返却された結果を表と説明文に整理します。Jev はその過程で評価を行います。
ワークフローが動作したら、入力要件、評価基準、ツールの呼び出し、レビュー規則を見出しレビューのSkillとして保存しましょう。次の資料バッチでも同じプロセスを再利用できます。提案の比較、コンテンツの分類、ログのトリアージなども、別の出発点として考えられます。
Provider はモデルへのアクセスを提供し、Skillはタスクを完了するための手法を保存します。 この記事に挙げた音楽、ゲーム、ルーティングのプロジェクトは設計上の参考になりますが、それらの完全な挙動を再現するには、関連するアプリケーションコードや実行ロジックが必要です。
判断に関する質問の設計ガイドについては、公式 TypeSafe Skill を参照してください。他のMCP統合を検討している開発者は、コミュニティのjev-mcpプロジェクトも参考にできます。
良い判断には明確な質問と確認できる結果が必要
Jevは、分類、スコアリング、選択をソフトウェアに組み込みやすくします。それでも、候補や評価基準、選択が誤った場合の対応は開発者が定義する必要があります。
TypeSafeは、計数、数学、日付比較、複雑な間接推論に関する制限を文書化しています。明示的な計算はコードに記述すべきであり、正しく構造化された出力であっても、その正確性は依然として確認する必要があります。既知のモデルの制限
これらのプロジェクトは、具体的な開発手法を示唆しています。ワークフローの中で繰り返し発生する意思決定を見つけ、十分なコンテキストを提供し、テスト可能な基準を定め、その結果を次のアクションに結びつけるのです。
まずは見出しを選んだり、Skillにルーティングしたり、ログをさらに深く調査する必要があるかどうかを判断したりすることから始めましょう。入力、判断、実行、レビューを連携させることで、再利用可能な機能を作り上げることができます。
Leina Agentでチャットから始めましょう
Agentの機能を試すには、まず**Leina Agent**から始めます。Agentを作成して実行し、チャットでやり取りしながら、GPTなどの会話型モデルを試し、タスクに応じてツールを追加しましょう。利用可能なモデルは、Leinaの現在の設定オプションによって異なります。
Leinaは、Discord、Slack、Microsoft Teams、WeChat、Feishu、DingTalkなど、一般的なメッセージングプラットフォームに対応しています。選んだチャンネルを接続すれば、ゲートウェイをデプロイしたりAPI呼び出しを自前で記述したりすることなく、スマートフォンやパソコンで普段使っているメッセージアプリからタスクを送信できます。
以下の3つのステップで始めましょう:
- Agentを作成する。 leina.ai にアクセスし、利用開始の案内に従って、Leina Agentを作成・実行します。
- メッセージングアプリを接続する。 選んだプラットフォームのセットアップ手順に従い、スマートフォンまたはパソコンから最初のメッセージを送信します。
- 簡単なタスクを試す。 概念の説明を求めたり、与えたテキストを整理させたり、いくつかの見出しを起草させたりしてみましょう。別のアプリへのアクセスが必要なタスクには、該当するConnectorを追加して権限を付与してください。
例えば、次のようなリクエストを送信します:
Jevを身近な例を挙げて説明した後、以下の資料から見出しを5つ作成してください。
タスクが増えてきたら、Agentに必要なConnectorを設定しましょう。これらのアプリ連携により、許可範囲内で他のサービスにアクセスし、チャットからの依頼を次の作業へとつなげることができます。ニーズに応じて異なるConnectorを選択でき、動作を確認したワークフローをSkillとして保存して再利用することも可能です。
本記事で紹介するJev評価ワークフローを試すには、Agent用にJev対応のCloudflare Workers AI Provider接続を設定し、前述の見出しレビューのリクエストを送信してください。会話型モデルは通常のチャットや見出し生成を担い、明示的なJev呼び出しにより、分類、スコアリング、選択の機能を試すことができます。
**LeinaでAgentを作成**して、まずはメッセージを1通送ってみましょう。すでにAgentをお持ちの場合でも、OOMOL Console からProviderを接続することで、既存の設定を維持できます。
情報源と範囲:本記事は2026年9月18日時点の調査に基づいています。TypeSafeの紹介記事、モデルドキュメント、制限事項は個別に確認しました。コミュニティプロジェクトの説明は、当該調査で確認した作者によるドキュメントに基づいています。デモおよび性能については、本記事のために独立してテストを行っていません。Providerの利用可能性、Leinaのオンボーディングおよびチャネルサポートについては、製品チームの情報とLeinaのウェブサイトを参考に記載しています。この記事では、当該Providerの実際に呼び出して検証した結果は報告していません。コミュニティによるアプリケーションや提案されたSkill拡張は、OOMOLが正式に出荷する完全なアプリケーションとは区別されます。