

 Leina
 Wanta
Apprendre à l’IA à choisir : 5 idées de Skills pour agents inspirées de Jev
Découvrez cinq usages de Jev, de la musique aux PNJ et au choix de Skills. Connectez Jev via le Cloudflare Workers AI Provider d’OOMOL ou commencez à discuter avec un Agent Leina.
OOMOL
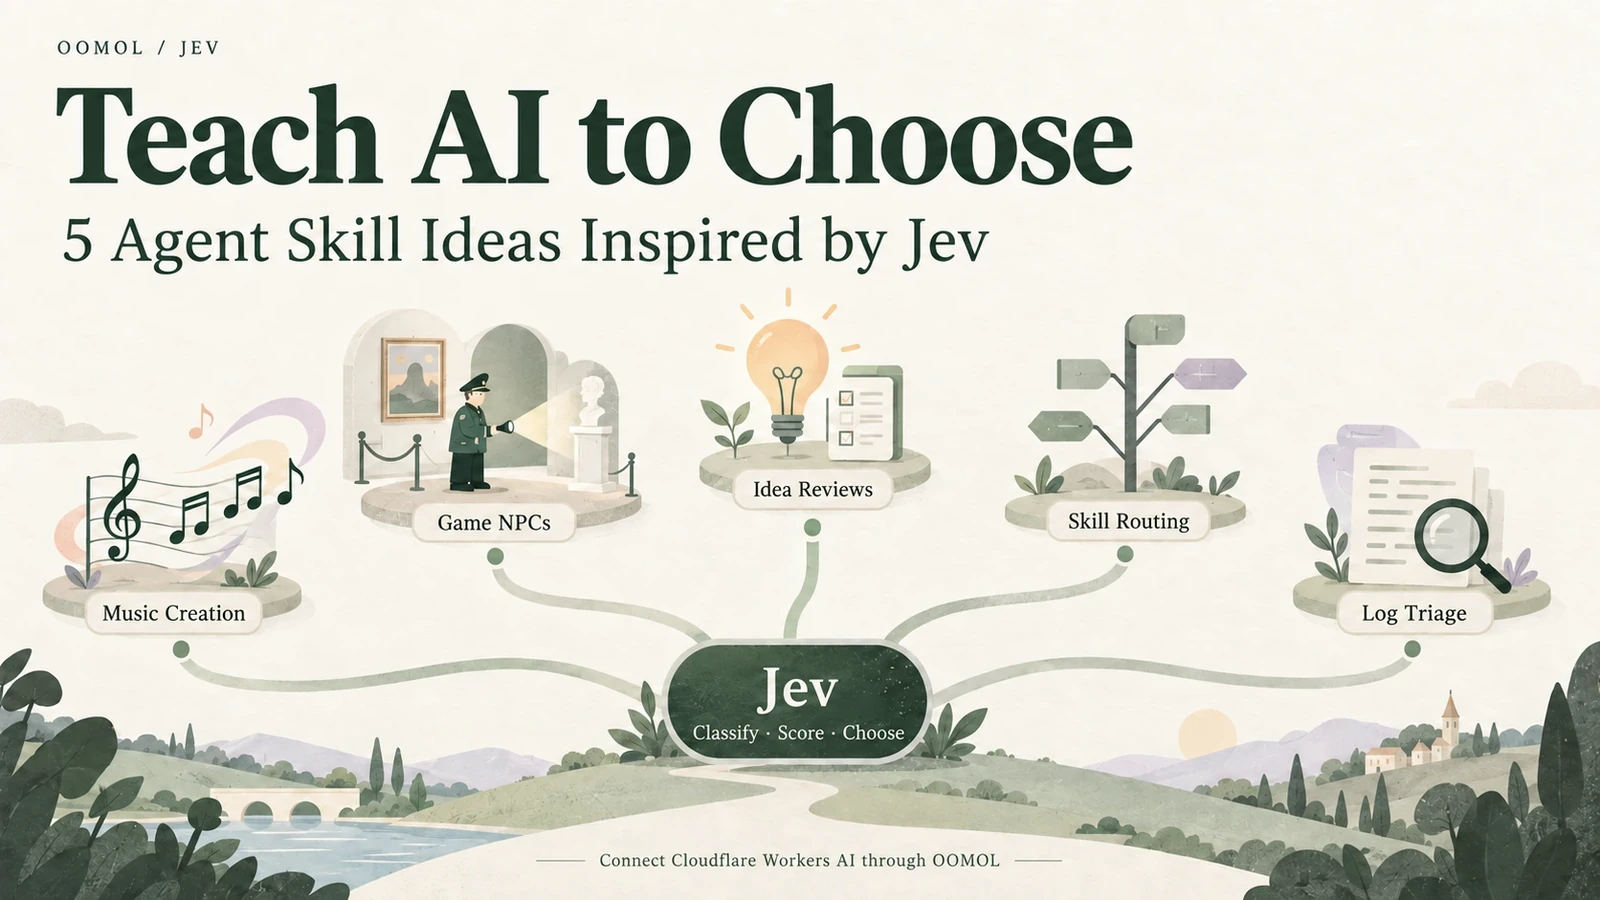
Vous avez dix propositions de titres. Lesquels conserver ? Vous avez installé des dizaines de Skills. Lequel convient à la prochaine requête ? Un garde dans un jeu repère une personne suspecte. Doit-il continuer sa patrouille, poser une question ou déclencher l’alarme ?
Chaque tâche peut ne renvoyer qu’un seul choix, mais faire ce choix exige de comprendre le contexte.
Jev, lancé en accès anticipé par TypeSafe le 15 septembre 2026, est conçu pour ces décisions. Il prend du texte ou un état structuré et retourne des choix ou des scores, accompagnés d’informations sur les probabilités, selon des types de questions prédéfinis. Les développeurs peuvent utiliser ces résultats pour déterminer la prochaine action de leur logiciel. Présentation de TypeSafe
Jev accepte actuellement des entrées textuelles. Les images, l’audio et la vidéo doivent d’abord être convertis en descriptions textuelles ou en champs structurés pour être évalués. Exigences d’entrée
Pour les lecteurs d’OOMOL travaillant avec des Agents et des Skills, cela suggère une approche utile : identifier un jugement récurrent dans un flux de travail, définir ses critères et regrouper la décision ainsi que les étapes suivantes dans une Skill réutilisable.
OOMOL propose désormais un Cloudflare Workers AI Provider compatible avec Jev. Une fois connecté, vous pouvez appeler Jev depuis vos workflows Agent et commencer à appliquer les idées ci-dessous à des tâches réelles.
Comment fonctionne Jev : transformer les jugements sémantiques en résultats exploitables par le logiciel
Jev est conçu pour les décisions structurées. TypeSafe appelle cette catégorie de modèles modèles System One. Une requête fournit un state contenant les éléments et le contexte à évaluer, ainsi que des questions définissant les jugements, les types de réponse et les critères. Le modèle renvoie des résultats typés que le code peut utiliser pour effectuer des branchements, des classements ou des routages. Aperçu technique
Il existe trois types de questions de base :
| Type | Objectif | Résultat |
|---|---|---|
| Choice | Sélectionner une option prédéfinie, comme une catégorie de message | L’option sélectionnée, une distribution de probabilités et un niveau de confiance |
| Score | Évaluer un degré selon des niveaux ordonnés prédéfinis | Un score, une distribution sur les niveaux et un niveau de confiance ; le score peut se situer entre deux niveaux |
| Noul | Juger si une affirmation spécifique est vraie | Une probabilité de « oui » comprise entre 0 et 1, sans champ de confiance distinct |
Les questions d’une même requête sont évaluées indépendamment et en parallèle sur le même état. Elles ne voient pas les réponses des autres. Si un jugement ultérieur a besoin d’un résultat antérieur, le code doit formuler une requête supplémentaire. Types de questions et composition
Les modèles génératifs de langage produisent généralement des réponses un jeton à la fois. TypeSafe décrit Jev comme utilisant un échantillonnage parallèle pour des sorties contraintes, retournant des décisions et des probabilités sans générer de réponse textuelle libre. Sa méthode d’entraînement est RLCD : Reinforcement Learning for Calibrated Decisions, qui vise à aligner les probabilités prévues avec les fréquences observées. Conception du modèle · Explication de RLCD
Pour un modèle bien calibré, les événements assignés à une probabilité de 80 % devraient se produire environ 80 % du temps sur de nombreuses prédictions comparables. Il s’agit d’un objectif statistique, non d’une garantie concernant une réponse individuelle. Le champ confidence des réponses Choice et Score résume la concentration de la distribution de probabilités ; il ne correspond pas simplement à la probabilité que la réponse sélectionnée soit correcte. Le code décide toujours quand agir, demander davantage d’informations ou solliciter une revue humaine, en s’appuyant sur des règles validées sur des exemples réels. Probabilités et confiance
Un exemple simple : acheminer le message d’un client
Imaginez qu’une boutique en ligne reçoive le message suivant :
La lampe est arrivée aujourd’hui, mais l’abat-jour est fissuré. Veuillez m’en envoyer une autre.
Un développeur fournit ce message comme state et définit trois questions. Les résultats ci-dessous sont des illustrations fictives, et non des sorties issues d’un appel réel au modèle :
| Question prédéfinie | Résultat illustratif | Utilisation par le code |
|---|---|---|
| Choice : S’agit-il d’une demande de remplacement, d’une question sur l’expédition, d’une interrogation avant-vente ou d’autre chose ? | Remplacement 92 %, expédition 3 %, avant-vente 1 %, autre 4 % ; sélectionner « remplacement » | Acheminer vers la file d’attente du support dédiée aux remplacements selon les règles de l’application |
| Noul : Le client demande-t-il explicitement un remplacement ? | 0,98, soit une probabilité estimée à 98 % de « oui » | Marquer le ticket comme une demande explicite de remplacement |
| Score : Le ton est-il calme, modérément mécontent ou très mécontent ? | Un score proche de « modérément mécontent » | Fournir à l’agent du support un signal supplémentaire pour examen |
Considérez-le comme un formulaire de tri : une personne définit les questions et les options, Jev évalue le message et le code décide où il va. Si le message est ambigu et que les probabilités sont réparties entre plusieurs options, l’application peut le transmettre à une personne pour vérification.
Le chiffre de 98 % fait référence à la probabilité d’une demande explicite de remplacement. Cela ne signifie pas que le client est « à 98 % insatisfait ». De même, le modèle n’a pas encore finalisé l’échange : vérifier la commande et la politique, rédiger une réponse et organiser un remplacement nécessitent d’autres outils, un modèle génératif ou un agent d’assistance.
Donnez à la génération, à l’évaluation et à l’exécution leurs propres rôles
Considérez un flux de travail pour choisir un titre d’article :
- Un modèle génératif élabore dix options à partir du contenu source.
- Jev les évalue selon des critères fixes tels que la clarté, la précision et la conformité aux informations fournies par la source.
- Le code agrège les résultats et présente les propositions ainsi que leurs scores à l’auteur.
Le modèle génératif propose des options, Jev évalue le sens, et le code s’occupe des calculs et de l’exécution. Une Skill décrit l’ensemble du processus : les entrées requises, les appels aux outils, la manière de gérer l’incertitude et ce qui doit être livré.
Cette répartition permet également de mieux cibler les débogages. Des titres peu percutants indiquent un problème dans les instructions de génération. Un classement peu utile invite à examiner plus attentivement les critères. Des totaux incorrects nécessitent de vérifier le code d’agrégation.
Les projets communautaires offrent déjà plusieurs exemples intéressants. Les cinq suivants incluent des outils disposant d’un fichier SKILL.md, ainsi que des applications et des bibliothèques. Les exemples applicatifs nécessitent une intégration supplémentaire avant qu’un Agent puisse les utiliser comme Skills.
1. Création musicale : choisissez les paramètres, puis générez les notes
Jev Playground décompose la création musicale en choix prédéfinis : ambiance, structure, tonalité, mesure, tempo, instrumentation et phrases. Jev sélectionne ces paramètres, puis un logiciel les transforme en notes, en partition et en lecture audio, avec possibilité d’export MIDI.
Cela offre aux créateurs de Skills un modèle concret. Un utilisateur pourrait décrire un objectif, comme de la musique d’ambiance pour lire le soir. Un flux de travail pourrait traduire cette demande en sélections de paramètres, appeler le programme musical existant et produire une partition ainsi qu’un fichier MIDI.
Ce serait une possible « Skill de planification musicale ». Ses contrôles proviennent de choix explicites : modifiez les réglages d’ambiance pour influencer l’atmosphère de la musique, ou ajustez le tempo et la mesure pour modifier le rythme.
Le projet inclut également un mode hors ligne qui utilise des heuristiques et ne nécessite aucune clé API. Lors de son utilisation, distinguez les résultats hors ligne des appels réels à Jev ; entendre simplement de la musique ne suffit pas à prouver que le modèle a participé.
2. PNJ de jeux : rendez les décisions d’un garde visibles
HEIST//ONE est un jeu d’infiltration se déroulant dans un musée. Déguisements, badges, éclairage et bruit influencent les décisions des gardes. Jev évalue la menace, la suspicion, l’intention tactique et les cibles d’attention, tandis que le code gère la physique, la recherche de chemin, les actions autorisées par les règles du jeu et les conditions de victoire.
L’interface peut afficher les éléments dont dispose un garde, les probabilités calculées par le modèle et l’action finalement exécutée.
Lorsqu’un garde se lance soudainement à la poursuite du joueur, le développeur peut examiner ce qu’il a vu, quel jugement a changé et comment le programme a traduit ce jugement en comportement.
Cela pourrait devenir un flux de décision réutilisable pour les PNJ : prendre l’état local perceptible par un personnage, choisir une action parmi un ensemble prédéfini et laisser le moteur du jeu valider et exécuter cette action. Les développeurs définissent les actions disponibles et les règles d’exécution.
Le projet fonctionne par défaut en mode scripté, sans nécessiter de clé API ; les appels réels au modèle nécessitent d’activer Jev. Son auteur a fourni des preuves d’une exécution réelle basée sur le modèle, mais une seule exécution ne garantit pas la fiabilité dans différents scénarios.
3. Évaluation d’idées : posez les mêmes questions à chaque proposition
Kill My Idea transforme l’évaluation des idées de startup en une petite application. Elle soumet dix questions à Jev, couvrant huit dimensions d’évaluation, la catégorie de l’idée et le degré de clarté de sa formulation. Le code pondère ensuite les scores pour recommander KILL (abandonner), FIX (réviser) ou SHIP (lancer).
La pondération des critères peut varier selon que l’objectif est de générer des revenus, de développer un projet open source ou de s’amuser.
Cela suggère une « Skill de comparaison d’idées » : prendre plusieurs propositions, les évaluer selon les mêmes dimensions et présenter leurs différences côte à côte. Cela pourrait aider les utilisateurs à identifier les idées clairement formulées, celles qui reposent sur des hypothèses non testées et celles qui mériteraient d’être expérimentées en premier.
Des critères cohérents facilitent la comparaison. Les scores doivent toutefois être confrontés à la réalité, notamment pour vérifier si les utilisateurs ont besoin du produit et s’ils sont prêts à l’utiliser ou à le payer. La documentation du projet indique que les évaluations réussies sont archivées sur le serveur par défaut, avec une option permettant de refuser cet archivage dans le formulaire.
4. Routage des Skills : laissez la possibilité de « pas de Skill nécessaire »
À mesure que la bibliothèque de Skills s’agrandit, choisir la bonne Skill devient crucial.
Jev Agent Skill Router prend une requête utilisateur et un catalogue de Skills, puis renvoie une Skill sélectionnée, une décision « pas de Skill » ou une demande de vérification. Le projet assure le routage ; d’autres logiciels doivent charger et exécuter la Skill choisie.
Pour les personnes qui gèrent de nombreuses Skills, cette distinction est utile. Un routeur doit tenir compte des limites des tâches ainsi que de leur pertinence. Une question conceptuelle peut ne nécessiter aucune Skill dédiée. Plusieurs Skills plausibles peuvent requérir une vérification supplémentaire. La décision de sauter une Skill n’exclut pas nécessairement l’utilisation d’un outil ultérieurement.
Un panneau affichant la demande, les candidats, la sélection et l’incertitude pourrait aider les mainteneurs à repérer des descriptions qui se recoupent, des responsabilités peu claires ou des déclencheurs trop larges.
Cette approche mérite d’être explorée dans un environnement d’Apps et de Skills comme OOMOL. Le projet communautaire en fournit l’idée ; intégrer un routeur complet demande encore du développement et de la validation.
5. Tri des logs : décider ce qui mérite une analyse plus approfondie
Jev Logs ajoute aux logs une valeur diagnostique, une priorité et des jugements de routage. Il aide à sélectionner quels logs méritent une analyse plus poussée par un modèle plus grand, tout en préservant l’archive originale. Le projet propose à la fois un package npm et un fichier SKILL.md. Il s’occupe du filtrage et du routage ; l’analyse des causes profondes relève du flux de travail en aval.
Ce modèle convient aux travaux de tri récurrents : identifier le contenu qui nécessite une attention particulière, puis faire appel à un modèle capable d’une analyse plus approfondie.
Conserver les preuves est essentiel. Les logs archivés permettent de vérifier si l’étape de tri a négligé quelque chose d’utile. Toute économie de coûts dépend de la distribution réelle des logs, des erreurs de filtrage et de la manière dont les modèles en aval sont sollicités.
Commencez par une Skill de revue de titres
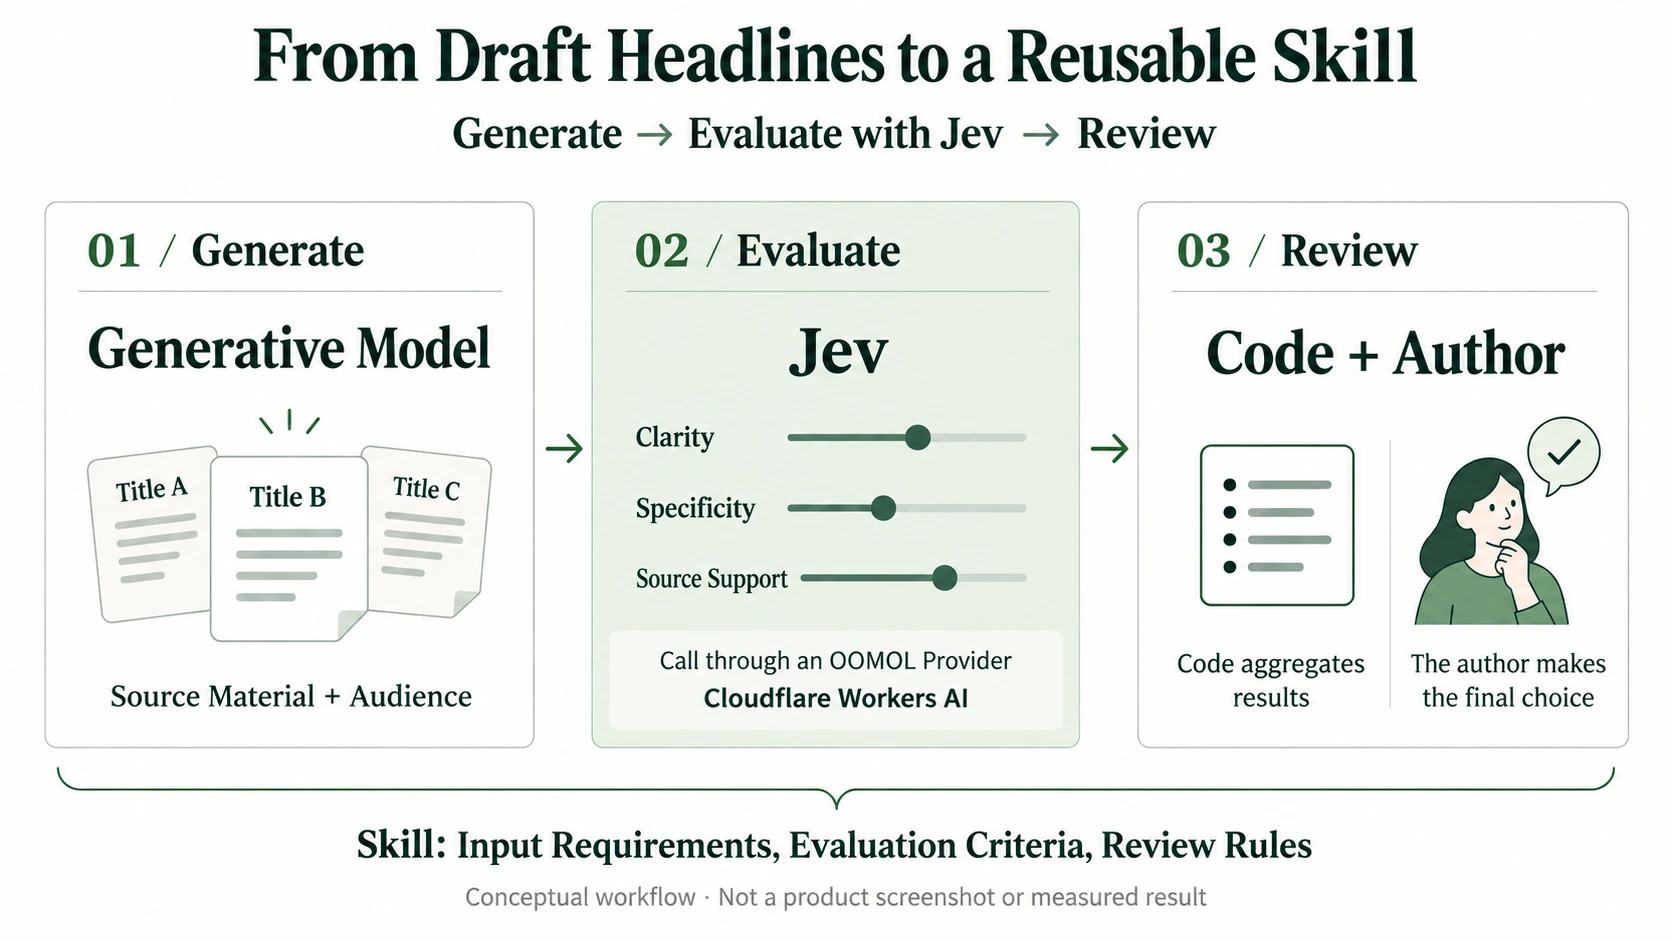
Figure 1 : Génération, évaluation et revue ont des rôles distincts. Il s’agit d’une illustration conceptuelle, et non d’une capture d’écran de produit ni d’un résultat mesuré.
Pour mettre ces idées en pratique, commencez par une tâche bien définie dont les résultats sont faciles à examiner, comme la revue de titres.
Vous pourriez définir la tâche ainsi :
Évaluer dix titres candidats par rapport au contenu source original. Examiner la clarté, la spécificité et déterminer si chaque titre contient des promesses que la source ne permet pas de justifier. Conserver les jugements individuels et signaler les candidats à revoir manuellement. L’auteur prendra la décision finale.
Puis précisez les attentes du flux de travail :
| Exigence | Exemple de revue de titres |
|---|---|
| Entrées | Contenu source, public cible et titres candidats |
| Critères d’évaluation | Le sujet est-il clair ? La formulation est-elle précise ? La source étaye-t-elle la promesse ? |
| Utilisation des résultats | Aider à la comparaison et à la revue tout en conservant chaque dimension |
| Exceptions | Demander à l’auteur de vérifier les preuves manquantes ou les jugements incertains |
| Validation | Vérifier des exemples réels, incluant des titres convaincants, peu clairs et ambigus |
Faites fonctionner ce petit flux avant de l’étendre à des lots plus importants ou à davantage d’outils. Pour le contenu chinois en particulier, TypeSafe indique que Jev obtient actuellement les meilleurs résultats en anglais ; les autres langues doivent être testées sur vos propres exemples. Prise en charge des modèles et des langues
Connectez le Provider dans OOMOL et commencez à utiliser Jev
OOMOL propose désormais un Cloudflare Workers AI Provider avec prise en charge de Jev. Connectez-le pour commencer à utiliser le modèle. TypeSafe développe Jev, Cloudflare en assure l’accès, et OOMOL rend cet accès disponible au sein du flux d’outils d’un Agent. Cloudflare répertorie Jev dans son catalogue de modèles.
Commencez par la tâche de revue de titres ci-dessus :
- Complétez la configuration de connexion du Provider Cloudflare Workers AI dans la console OOMOL.
- Préparez votre contenu source et vos titres candidats. Indiquez à votre Agent les dimensions à comparer et demandez-lui explicitement d’appeler Jev.
- Examinez les jugements retournés, identifiez les candidats qui nécessitent une révision ou un examen plus attentif, et décidez de la marche à suivre.
Une fois connecté, vous pouvez donner à votre Agent une instruction comme celle-ci :
Utilisez le Provider Cloudflare Workers AI connecté pour appeler Jev et évaluer les dix titres suivants. En vous basant sur le contenu source original, évaluez la clarté, la spécificité et déterminez si l’un des titres contient une promesse non étayée. Présentez les résultats sous forme de tableau comparatif, conservez chaque jugement et listez les titres que je dois examiner séparément.
L’Agent transforme la tâche en questions que Jev peut traiter, puis organise les résultats retournés en tableau et en texte explicatif. Jev se charge des jugements dans ce processus.
Une fois le flux opérationnel, enregistrez les exigences d’entrée, les critères d’évaluation, les appels aux outils et les règles de revue en tant que Skill de revue de titres. Vous pourrez réutiliser la même procédure avec le prochain lot de contenu. La comparaison de propositions, la classification de contenus et le tri de logs constituent d’autres points de départ possibles.
Le Provider vous donne accès au modèle ; la Skill conserve la méthode pour mener à bien une tâche. Les projets musicaux, ludiques et de routage présentés dans cet article offrent des références de conception. Reproduire leur comportement complet nécessite toutefois le code applicatif et la logique d’exécution correspondants.
Pour obtenir des conseils sur la conception de questions d’évaluation, consultez la Skill officielle de TypeSafe. Les développeurs envisageant une autre intégration MCP peuvent également se tourner vers le projet communautaire jev-mcp.
De bonnes décisions nécessitent des questions claires et des résultats vérifiables
Jev simplifie l’intégration de la classification, de la notation et de la sélection dans les logiciels. Les développeurs doivent toutefois définir les candidats, les critères d’évaluation et les actions à entreprendre en cas de choix erroné.
TypeSafe documente les limitations liées au comptage, aux calculs mathématiques, aux comparaisons de dates et au raisonnement indirect complexe. Les calculs explicites doivent être réalisés en code, et même un résultat correctement structuré doit encore être vérifié pour s’assurer de sa validité. Limitations connues du modèle
Ces projets suggèrent une approche concrète de développement : identifiez une décision récurrente dans votre flux de travail, fournissez suffisamment de contexte, définissez des critères que vous pouvez tester et reliez le résultat à l’étape suivante.
Commencez par choisir un titre, orienter vers une Skill ou décider si un journal nécessite une analyse plus approfondie. Lier les entrées, les évaluations, l’exécution et la revue crée une capacité que vous pourrez réutiliser.
Commencez par discuter avec un Agent Leina
Pour découvrir ce qu’un Agent peut faire, commencez avec Leina Agent. Créez et lancez un Agent, discutez avec lui, explorez des modèles conversationnels tels que GPT et ajoutez des outils selon vos besoins. Les modèles disponibles dépendent des options de configuration actuelles de Leina.
Leina prend en charge les plateformes de messagerie courantes, notamment Discord, Slack, Microsoft Teams, WeChat, Feishu et DingTalk. Une fois votre canal choisi connecté, vous pouvez envoyer des tâches depuis l’application de messagerie que vous utilisez déjà sur votre téléphone ou votre ordinateur, sans avoir à déployer de passerelle ni à écrire vous-même des appels API.
Commencez en trois étapes :
- Créez un Agent. Rendez-vous sur leina.ai, suivez le guide de démarrage et créez puis lancez votre Agent Leina.
- Connectez votre application de messagerie. Suivez les instructions d’installation pour la plateforme de votre choix, puis envoyez votre premier message depuis votre téléphone ou votre ordinateur.
- Essayez une petite tâche. Demandez-lui d’expliquer un concept, d’organiser le texte que vous lui fournissez ou de rédiger quelques titres. Ajoutez et autorisez le Connector approprié lorsque la tâche nécessite l’accès à une autre application.
Par exemple, envoyez-lui cette requête :
Expliquez Jev à l’aide d’un exemple concret, puis rédigez cinq titres à partir du contenu source ci-dessous.
Au fur et à mesure que vos tâches se multiplient, configurez les Connectors dont votre Agent a besoin. Ces connexions applicatives lui permettent d’accéder à d’autres services dans le cadre des permissions que vous lui accordez et de poursuivre le travail à partir d’une demande formulée dans le chat. Vous pouvez choisir différents Connectors en fonction de vos besoins et enregistrer un processus opérationnel sous forme de Skill afin de le réutiliser.
Pour essayer le flux d’évaluation avec Jev présenté dans cet article, configurez pour votre Agent une connexion au Provider Cloudflare Workers AI avec prise en charge de Jev, puis envoyez la requête de révision de titres mentionnée ci-dessus. Le modèle conversationnel gère les échanges ordinaires et la génération de titres ; un appel explicite à Jev vous permettra de tester ses capacités de classification, de notation et de sélection.
Visitez Leina et créez votre Agent, en commençant par un seul message. Si vous avez déjà un Agent, vous pouvez également connecter le Provider via la console OOMOL tout en conservant votre configuration existante.
Sources et périmètre : Cet article est basé sur des recherches datées du 18 septembre 2026, les introductions, la documentation et les limitations de TypeSafe ayant été vérifiées séparément. Les descriptions des projets communautaires proviennent de la documentation des auteurs examinée lors de ces recherches ; les démos et les performances n’ont pas été testées indépendamment pour cet article. La disponibilité des Providers ainsi que la prise en main et la prise en charge des canaux par Leina sont présentés sur la base des informations de l’équipe produit et du site web de Leina ; cet article ne rapporte pas de test en direct de ce Provider. Les applications communautaires et les extensions de Skill proposées se distinguent des applications complètes livrées par OOMOL.