

 Leina
 Wanta
AIエージェント時代に、なぜワークフローが必要なのか?
エージェントも定期実行できます。固定の業務ルール、人による承認、バージョン管理を通じて、ワークフローが役立つ場面とOpen Flowとの連携を考えます。
OOMOL
毎朝9時にエージェントが注文を分析し、レポートを送る。開始するだけなら、定期実行のジョブを設定できます。イベントやWebhookを使えば、データの変更をきっかけに作業を始めることもできます。
レポートが期待どおりで、処理も単純なら、それで十分かもしれません。
しばらく運用すると、要件が具体的になることがあります。返金率は統一した定義で計算する。分析対象は指定範囲に限る。顧客へのメッセージは送信前に承認を受ける。計算ルールを変更した後は、旧版を使ったレポートを確認できるようにする。
ここで考えるべきなのは、どの判断を実行中のエージェントに任せ、どの手順を決めたルールに従わせるかです。承認待ちの状態はどこに保存するのか。別の担当者が処理を理解し、保守できるのかも問題になります。
ワークフローは、こうした要件を整理する方法です。手順、データの関係、承認条件を明示的に保存し、実行システムが進行状態を管理します。エージェントは構築を手伝い、理解や判断が必要な処理を担当できます。
確定したルールを同じ方法で実行する
注文の日次レポートでは、金額の合計、ステータス別の集計、期間の絞り込みに明確なルールがあります。返金率の分母は全注文か、支払い済みの注文か。注文日で集計するのか、返金日で集計するのか。定義が決まったら、コードに反映する必要があります。
エージェントもそのコードを呼び出せます。ワークフローはさらに、データの取得元、計算結果を渡すノード、送信を続ける条件など、ほかの手順との関係を保存します。一つずつ確認できる形になります。
顧客のコメントの意味や、異常の背景として考えられること、要約で強調すべき点はAIに任せられます。例えば、コードで異常な注文を抽出し、その記録をモデルに渡して、要約を通知の手順へ送ります。
ここで固定されるのは、計算ルールと実行の構造です。モデルの判断は変わる可能性がありますが、受け取るデータ、担当する仕事、出力の用途は明確になります。
承認を待つ間も進行状態を保つ
顧客への返信を考えてみましょう。エージェントはメールを読み、注文を確認し、返信案を作りました。次は担当者の承認を待ちます。
担当者が確認するのは数時間後かもしれません。システムは入力、返信案、完了した手順、承認または却下後の動作を保存する必要があります。再開時には同じ実行の状態を使い、完了済みの手順を繰り返さないようにします。
こうした仕組みはエージェントのシステムにも実装できます。ワークフロー基盤を選ぶ際は、どの状態管理機能が用意されているか、途中の待機、人の判断、実行の再開に対応できるかを確認することが大切です。
トリガーは作業を開始し、通知や後続のAPI呼び出しは結果を届けます。定期実行、イベント、Webhook、ポーリングは、エージェントにもフローにも使えます。次の図は、開始後にルール、AI、承認、通知がどうつながるかを示しています。
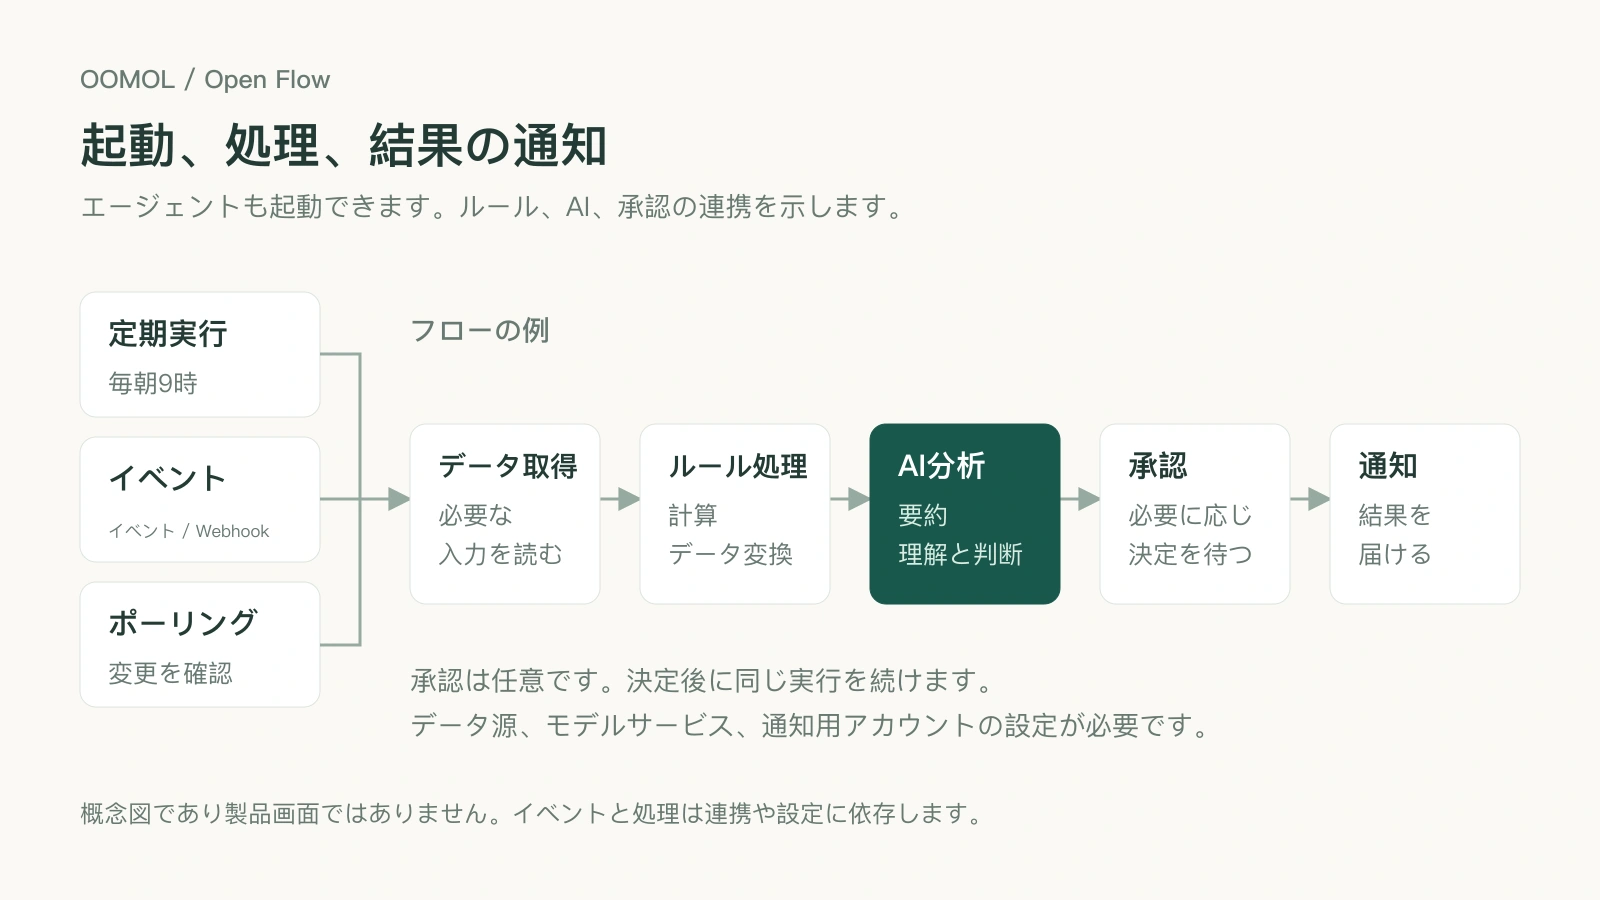
自分で構築できるフローの例です。トリガーは用途に応じて選び、承認は任意の手順です。実行にはデータソース、モデルサービス、通知用アカウントの設定が必要です。
Open FlowのApprovalとWaitノードは待機状態を永続化します。決定後は、完了済みの手順を繰り返さずに同じ実行を続けられます。人が途中で関与する仕事では、具体的に評価できる機能です。承認と実行の説明
担当者が変わっても保守できるか
最初はエージェントに何度か試してもらい、データソース、集計の定義、レポート形式を決めていくことがあります。ほかの人も保守するようになったら、その決定を残す必要があります。
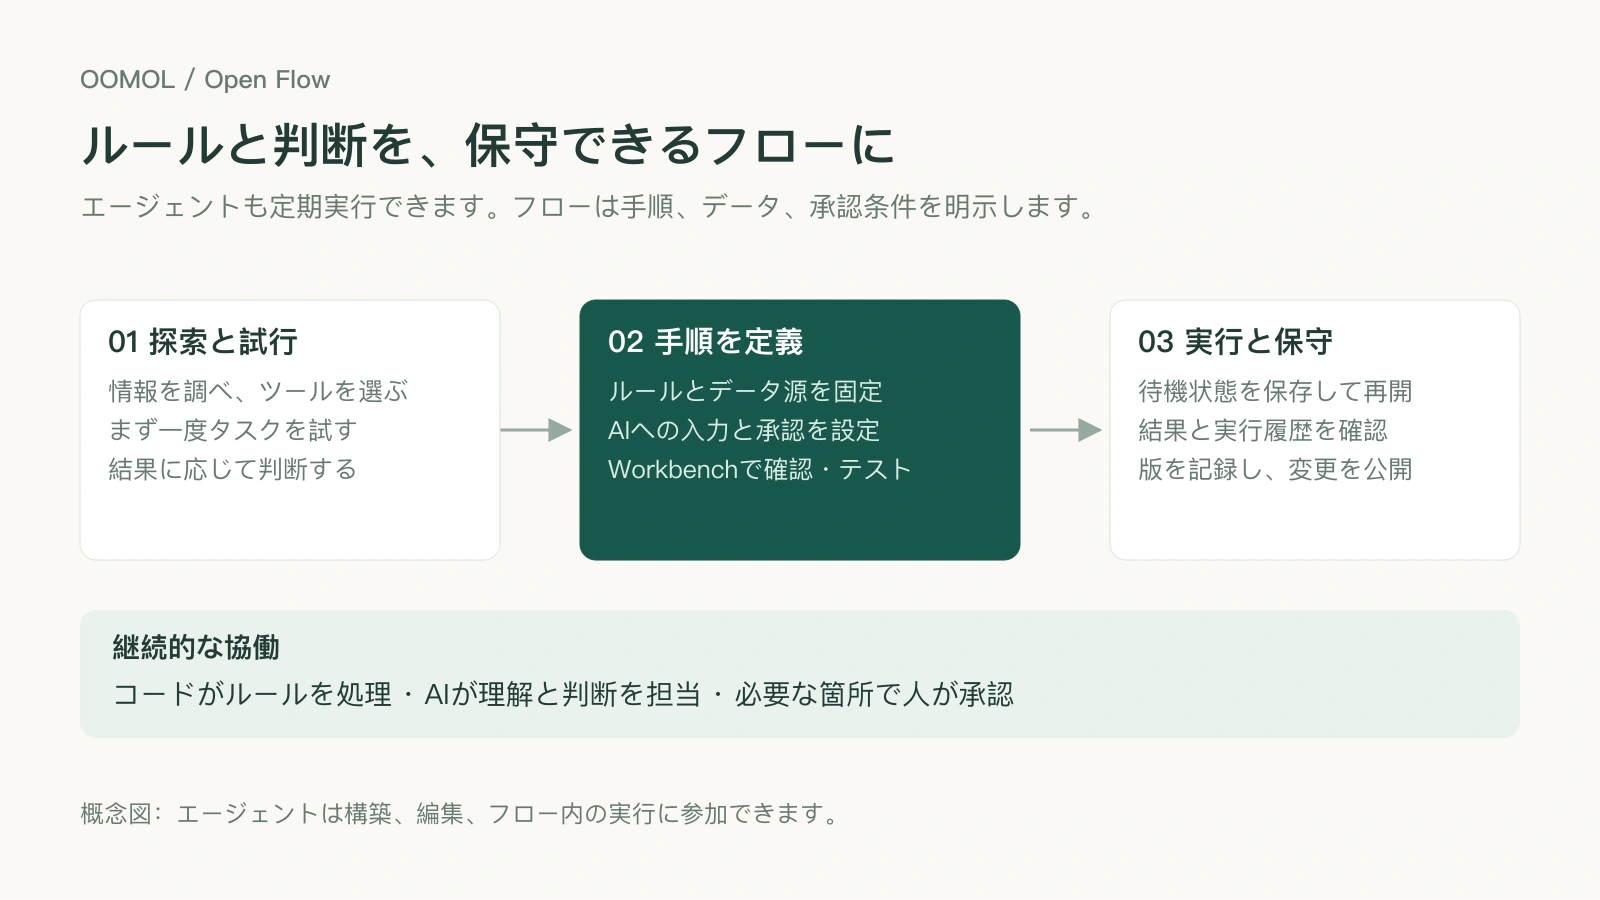
保守担当者は、注文を読む手順、返金率を計算する場所、モデルに渡すデータ、メッセージを送る条件を知る必要があります。フロー図、入力の対応付け、ノードのコードがその理解を助けます。プロジェクトの説明と設定も引き続き管理が必要です。
変更後には、各実行がどの版のロジックを使ったかも確認します。月曜日に返金率の定義を変えたなら、先週のレポートを調べるには当時のコードと入力が必要です。実行記録を特定のバージョンと関連付ければ、結果を照合できます。
既存のエージェントシステムにこれらの機能があれば、そのまま使えます。ワークフロー基盤は一般的な仕組みをまとめて提供し、チームが自分で構築・保守する範囲を減らします。
Open Flowで保存し、実行する
Open FlowはOOMOLのオープンソースのワークフロー基盤です。OOMOL Flowで公式ホスティング版を使うか、GitHubリポジトリでソースコードとセルフホスティングの手順を確認できます。エージェントが作成したFlowを、可視化ワークベンチのWorkbenchで確認し、同じフローを編集できます。
エージェントはoo flowでノードを作成し、下書きを検査し、テスト実行と結果の確認を行います。Workbenchではデータの取得元、各手順のコード、分岐条件を確認できます。対応クライアントはServerのMCPツールでもフローを構築・実行できます。
日次レポートなら、Code TaskでJavaScriptによる計算と変換を行い、LLM Taskで要約を生成します。複数のツール呼び出しが必要ならAgent Taskを使います。入出力には明確な名前と型があり、繰り返すロジックはサブフローにまとめられます。
公開後にもフローの変更は必要です。Open Flowは公開時にバージョン付きのスナップショットを作り、Liveの自動処理で使います。下書きの編集とテストを続け、準備ができたら新しい版を公開できます。実行履歴は対応するリビジョンに関連付けられ、レポートを生成したコードとフローを確認できます。
外部アプリのデータ取得や通知には、必要なアカウントと権限の設定が必要です。Open FlowはOpenConnectorなどのConnectorランタイムで操作を実行します。認証情報はConnectorが保持し、Flowは接続の識別子を参照します。機能と運用方法を見る
公式ホスティング版の運用はOOMOLが担当します。セルフホスティングでは、ストレージ、バックアップ、更新、サービス接続をチームで管理します。ライセンスはApache-2.0で、現在はBetaです。アカウント接続とエージェントの設定はFlow入門ガイドを参照してください。
実際の仕事で試す
固定ルールや人の承認が必要な繰り返し作業を一つ選びます。OOMOL Flowを開き、必要なデータソースと通知用アカウントを接続して、エージェントに依頼してください。
注文の日次レポート用Flowを作成してください。前日の注文を読み、私が確認した定義で金額と返金率を計算し、AIで異常を要約して、指定したチームのチャンネルに送ります。まず下書きを作成してテストし、結果を私が確認してから公開してください。
Workbenchでデータ、コード、出力を確認します。定期実行するエージェントで十分なら、その方法を続けられます。明確なルール、承認、バージョン履歴が必要なときに、このFlowを運用するか判断してください。
- OOMOL Flowを開いて、最初のワークフローを作成する
- セルフホスティングや開発への参加を考えている方は、Open Flowのソースコードとデプロイ手順をご覧ください。